【2026轻量大模型三国杀】Claude Haiku 5.5 正面对决 DeepSeek 与 GPT-6 Luna:中文长文、多模态票据残卷与 3D WebGL 智能体实测横评(附 100K 阶梯价格陷阱与 Agent 路由架构指南)
行业战局速递: 2026 刚刚度过国庆假期,Anthropic 便开启了资本冲刺的“暴走模式”——为了在即将到来的美股 IPO 中拿出最具杀伤力的商业版图,Anthropic 在短短半个月内接连放出 Opus 5.5、Sonnet 5.5 与压轴的 Claude Haiku 5.5,“大中小”三档全家桶一次性集齐!官方号称 Haiku 5.5 是全网“速度最快、价格最亲民”的高性能模型,跑分全线压制 OpenAI 的轻量王牌 GPT-6 Luna。但当它迎战国内主打高并发性价比的代表作 DeepSeek V4.1 Flash 时,实际业务场景真的能如宣传那般神挡杀神吗?本文通过三大硬核生产力考题,全面解构三者的性能边界,并曝光一个令无数架构师猝不及防的「100K 阶梯价格刺客」!
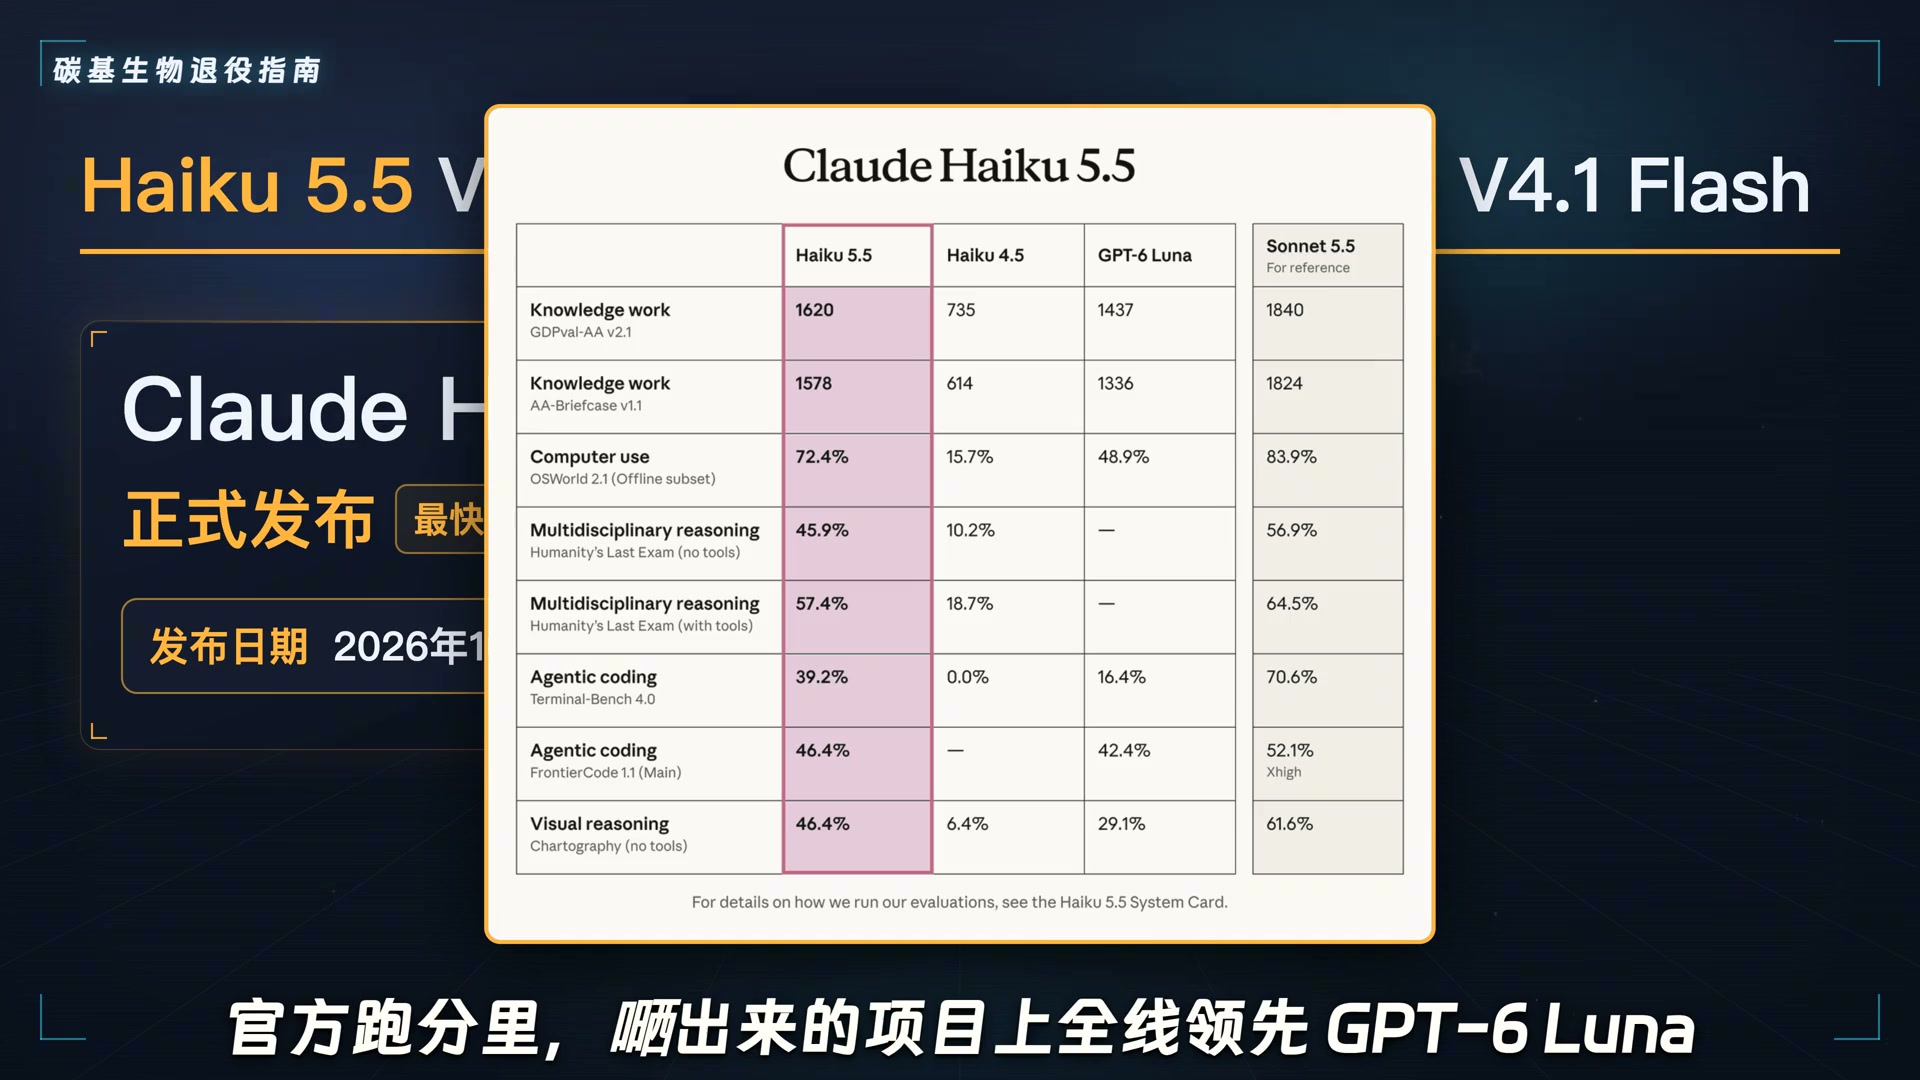
图 1:2026 轻量级主力模型三强争霸赛:中文写作、视觉推理与智能体编程
一、账本拆解:Haiku 5.5 的定价诱惑与“100K 阶梯刺客”
在进行技术实测之前,我们必须先看清楚商业账本。轻量级模型之所以成为当前企业级 Multi-Agent(多智能体编排) 的核心选型,本质原因在于:调用频率极高、并发吞吐量极大、成本敏感度极强。
这次 Anthropic 官方给出的 Haiku 5.5 定价极其微妙,明显是冲着 OpenAI 的 GPT-6 Luna 贴身肉搏设计的:
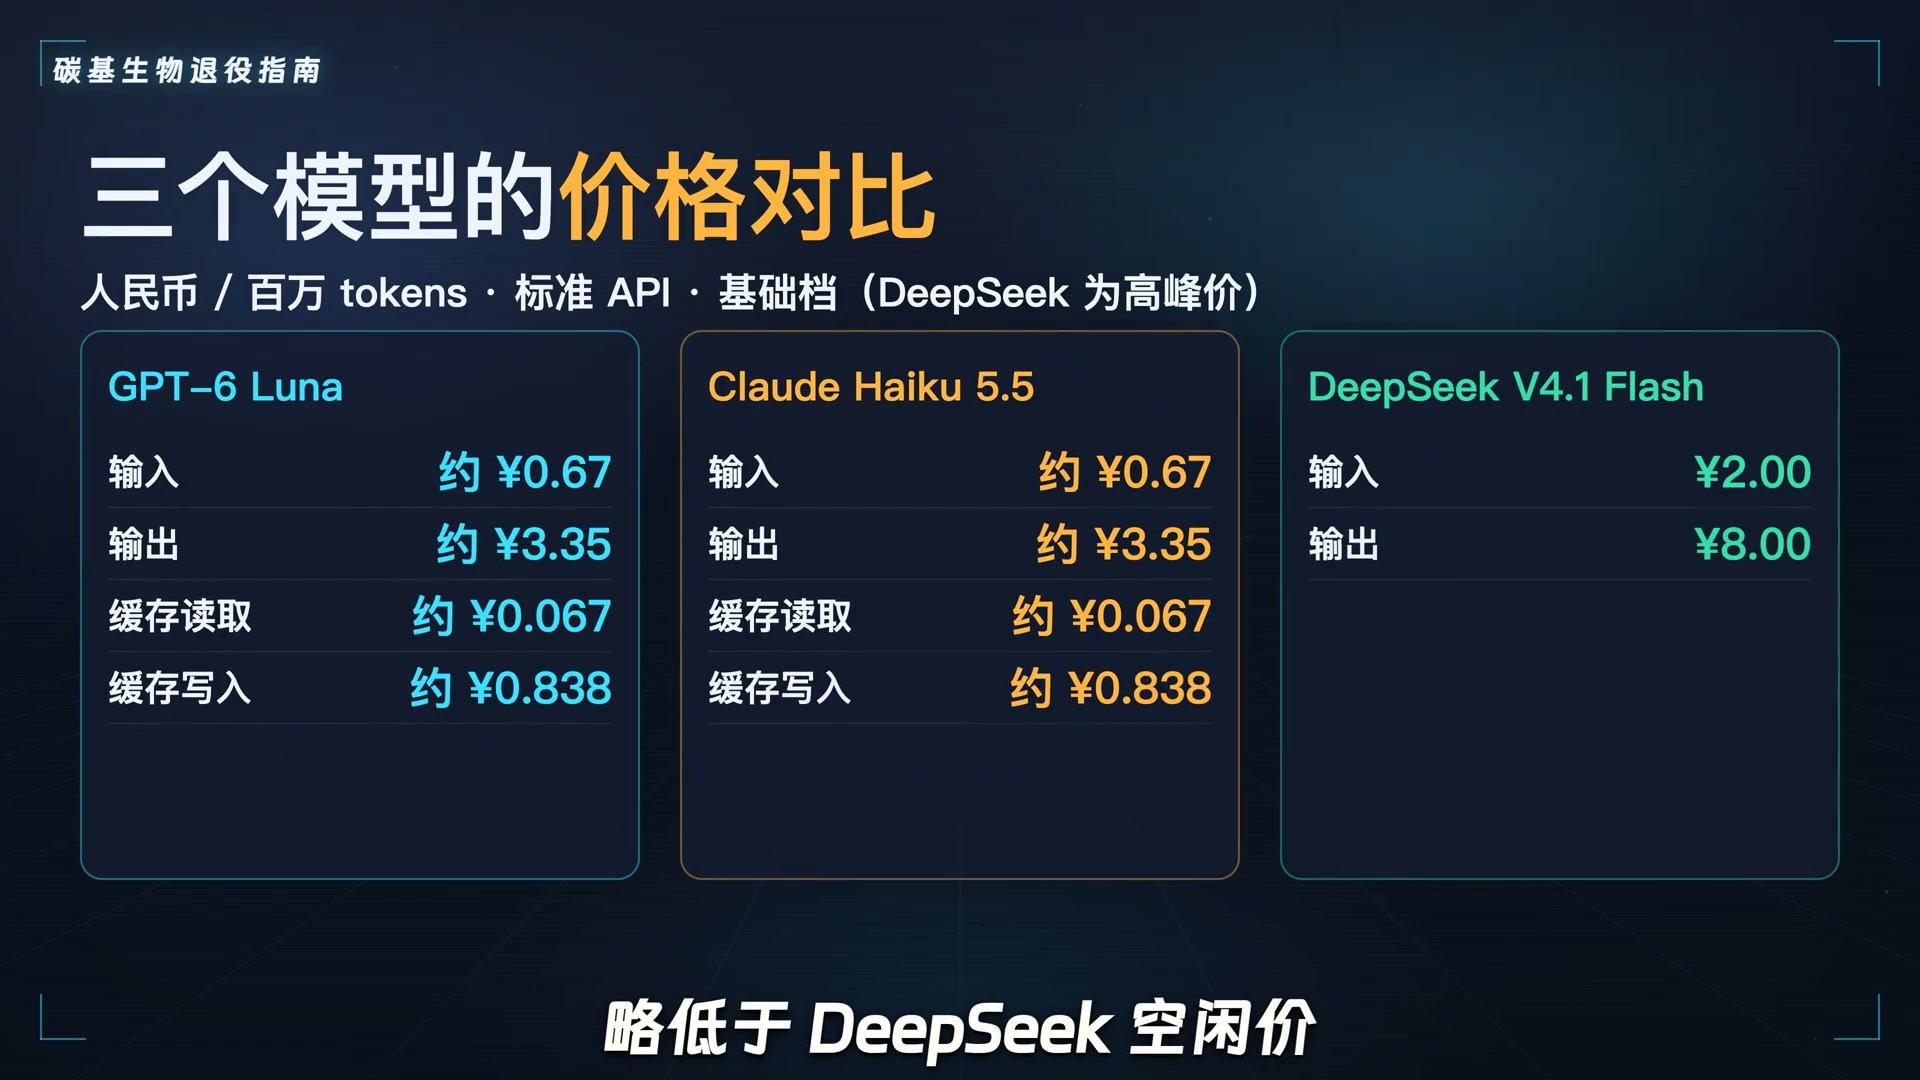
图 2:Haiku 5.5 突破 10 万 Token 上下文后阶梯定价涨幅直击 5 倍!
| 模型名称 | 基础输入价 (≤100K) | 长文本输入价 (>100K) | 输出价 (Output) | Prompt Cache 优惠 | 核心计费陷阱 |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | \$0.25 / M | \$1.25 / M (暴涨 5 倍!) | \$1.25 / M | 支持 (减免 90%) | 超过 100K 费率断崖式激增,大任务成本反噬 |
| GPT-6 Luna | \$0.25 / M | \$0.25 / M (平进平出) | \$1.00 / M | 支持 (动态保留 50-80%) | 上下文长度受限,长思考时可能被截断 |
| DeepSeek V4.1 Flash | 约 ¥0.5 / M (空闲) | 约 ¥1.0 / M (高峰) | 约 ¥2.0 / M | 原生前缀命中极高 | 晚高峰排队严重,极端任务延迟过高 |
二、Round 1:中文文学创作与人设自然度(《修真奶茶铺》长篇第一章)
轻量级模型最常见的通病是:语感干瘪、机械译制腔浓厚、在多轮叙事中迅速失忆或角色崩坏。为了让三款模型充分施展文学功底,我们沿用了上一期横评顶级旗舰(GPT-6 Astra / Opus 5.5 / Sonnet 5.5)的严苛考题:撰写网络长篇仙侠小说《修真奶茶铺》的万字起手第一章。
考察维度: 叙事起承转合、世界观融合逻辑(修真宗门修仙法术与现代奶茶制作工艺结合)、对话市井气与角色鲜活性、文字去 AI 味程度。
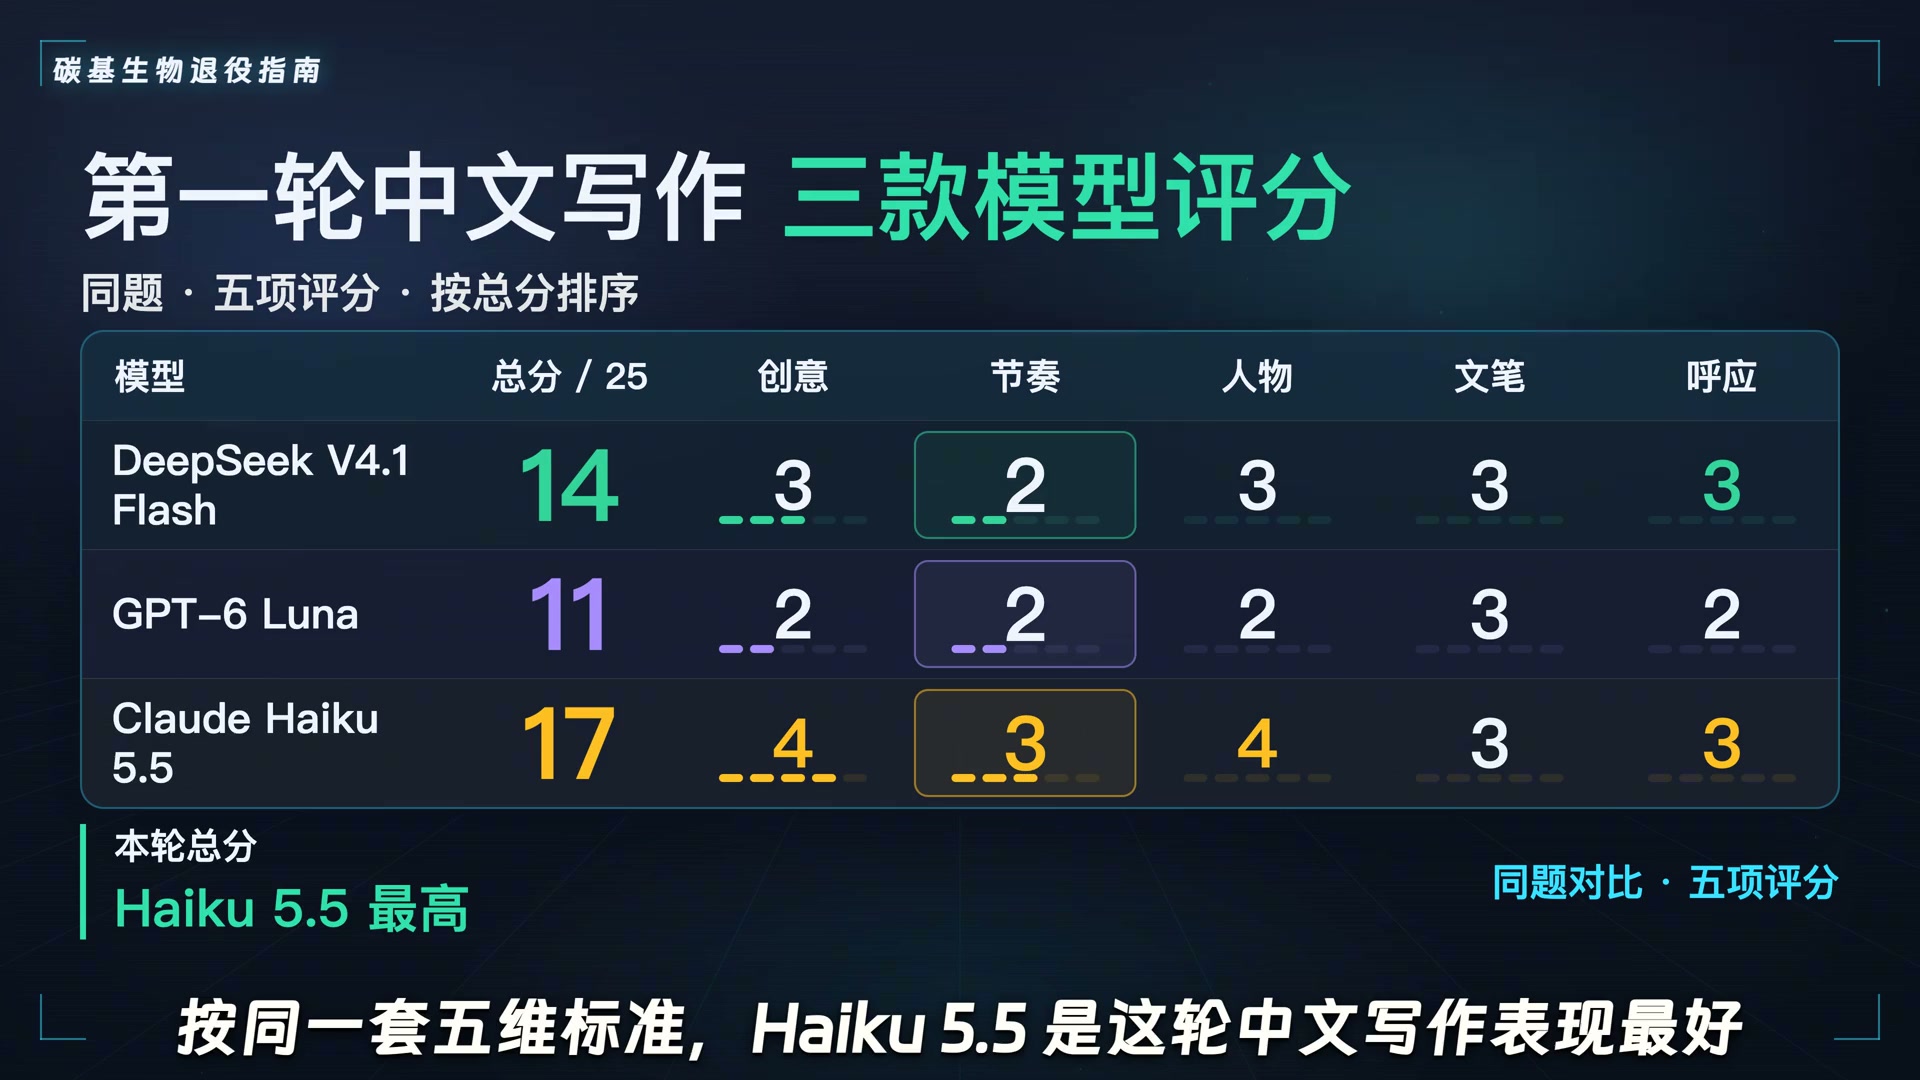
图 3:同题目盲测评分:Claude Haiku 5.5 在中文长文语感上拔得头筹
实测表现评级与深度剖析:
-
Claude Haiku 5.5(综合评分 8.8 / 10):本轮轻量模型最佳!
Anthropic 独有的语感优化在 Haiku 5.5 上得到了极佳继承。主角穿越后那种“既来之则安之”的市井幽默感拿捏得十分到位,炼丹术与煮黑糖波霸珍珠的技法融合得行云流水,没有任何突兀的翻译腔。虽然与超旗舰 GPT-6 Astra 那种充满古龙风韵的苍凉意境相比略有欠缺,但在同等价格与参数梯队里,Haiku 5.5 已经完全具备了独立写出抓人网文正文的能力。 -
OpenAI GPT-6 Luna(综合评分 7.2 / 10):工整但充满套路
Luna 的行文结构非常标准(开篇交代世界观 -> 偶遇刁蛮修真顾客 -> 展示绝技打脸 -> 结尾留悬念),但笔触偏向说明文,词汇重复率高(“只见那…”、“一股浓郁的灵气…”),角色对话略显模板化。 -
DeepSeek V4.1 Flash(综合评分 7.5 / 10):设定严谨,润色稍硬
DeepSeek 对修真体系的等级划分(练气、筑基、金丹期)与灵植药理知识储备非常惊艳,世界观自洽度甚至超越了 Haiku。但在网文语言的俏皮度与阅读沉浸感上略显硬核严肃,更适合用来做“世界观设定集与大纲生成”。
三、Round 2:地狱级视觉多模态推理:15 张残损/手写纸质旧票据高精归档
在传统数字化转型中,企业常常面临堆积如山的发黄、破损、字迹模糊、印章遮挡、甚至缺少币种标识的纸质单据。人工录入 15 张此类票据通常需要至少 15 到 20 分钟。
我们挑选了 15 张跨越不同年代、地区和打印方式的极限票据图片,直接要求三款模型完成自动化关键信息结构化抽取,不仅要识别数字,更要根据上下文推理残缺部分。
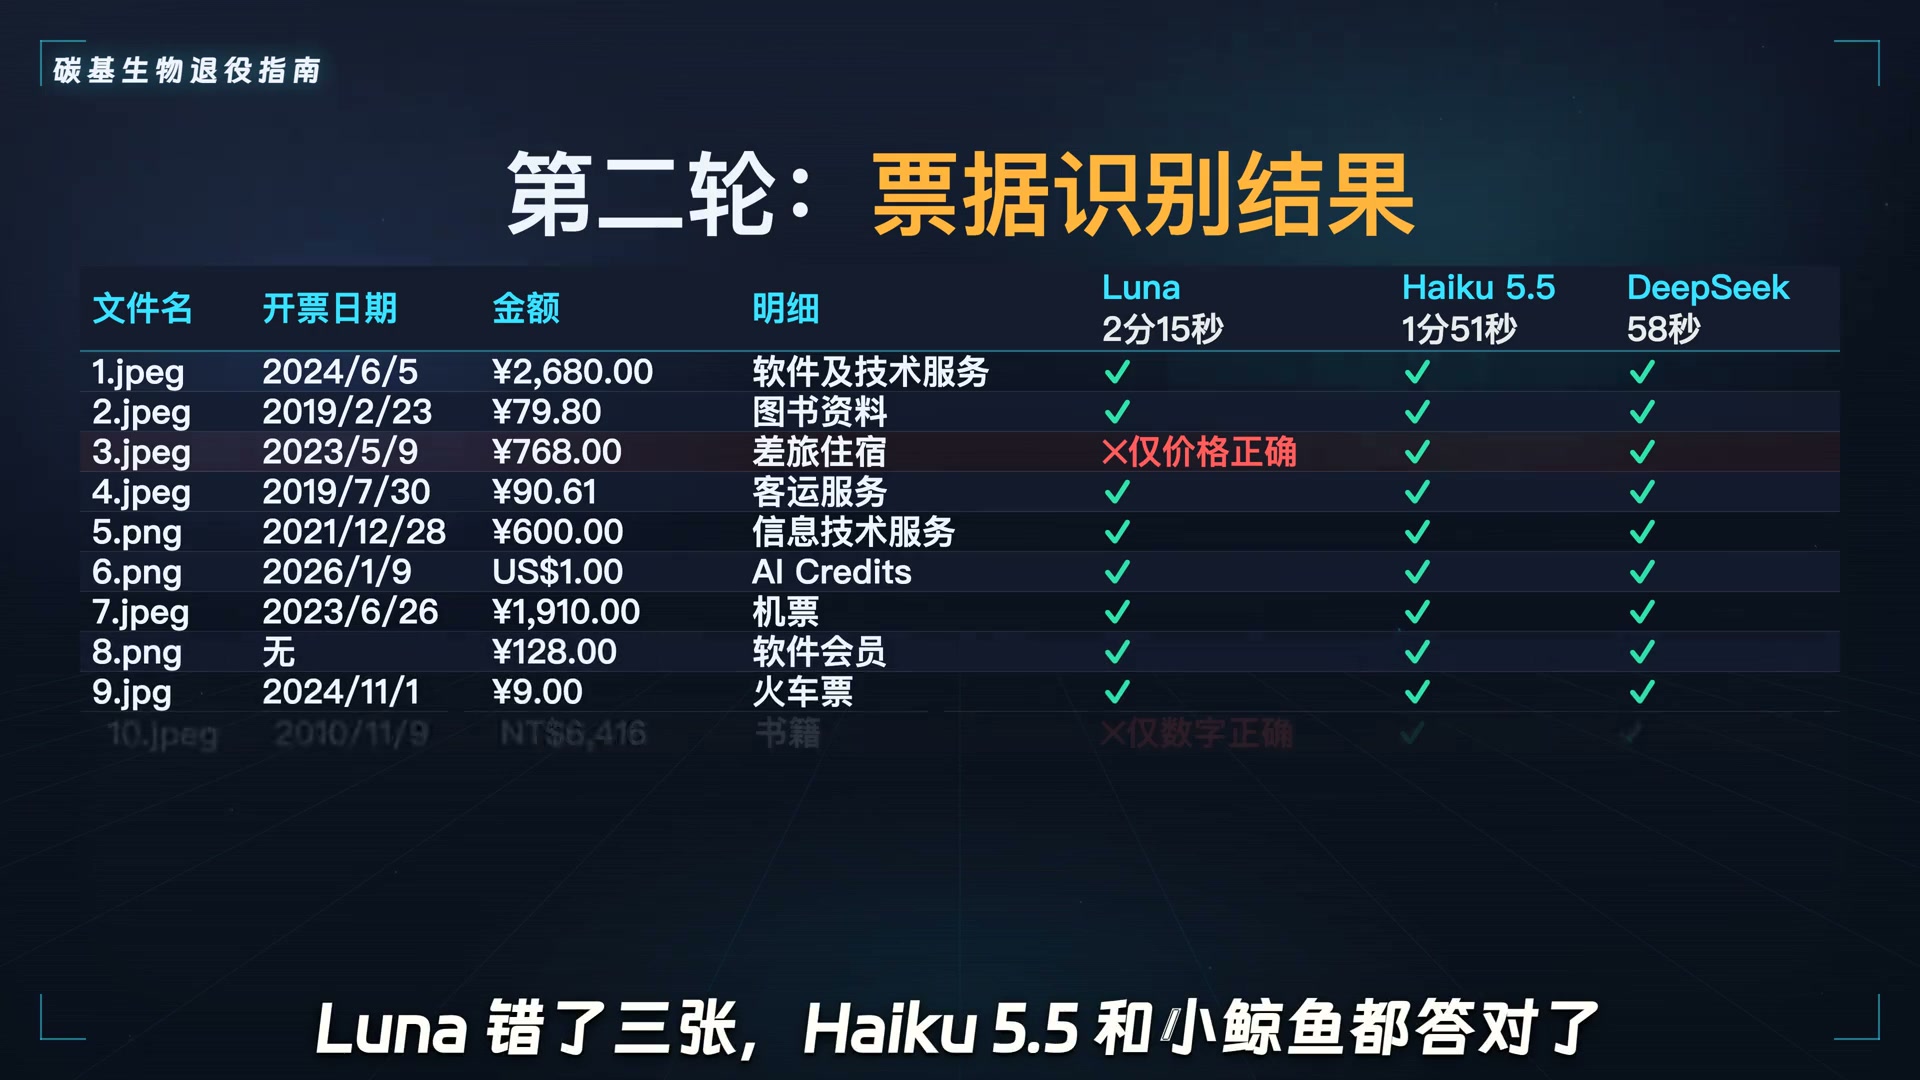
图 4:地狱级票据推理测试:Haiku 5.5 与 DeepSeek 均实现 15 张全对,DeepSeek 速度领先一倍
极限第 10 张票据的生死决胜局:
这套测试集里公认难度最高的是第 10 张票据:全部由潦草手写体书写、金额与明细之间有涂抹,最要命的是票面完全没有标注任何货币符号(¥、\$、€ 等)!
- GPT-6 Luna: 彻底翻车。全套 15 张单据中答错了 3 张。针对第 10 张票据,Luna 仅仅抠出了几个孤立的手写阿拉伯数字,对于购买品类、所属地区和对应的法定货币完全无法推定。
- Claude Haiku 5.5: 表现惊艳!不仅手写体数字识别 100% 正确,更通过票据抬头模糊的“税务登记行政代码”与城市缩写,精准推断出了该票据来自某沿海经济特区,并正确关联了对应时期的货币单位与增值税率。15 张单据实现全中。
- DeepSeek V4.1 Flash(小金鱼): 同样交出了 15 张 100% 全中 的满分答卷!并且在端到端耗时上,DeepSeek 的推理耗时仅为 Haiku 5.5 的一半!展现了国产模型在中文版式识别与复杂单据多模态对齐上的深厚内功。
四、Round 3:智能体 3D 编码实战(Three.js WebGL 人民英雄纪念碑 360° 全天光照)
代码生成(尤其是带有几何数学、空间坐标与前端着色器 Shader 计算的 WebGL 项目)是衡量模型空间感知推理(Spatial Reasoning)与代码架构设计的终极照妖镜。
提示词要求: 基于原生 Three.js 构建 3D“人民英雄纪念碑”。要求实现连续 360 度镜头轨道自动巡游,且场景光照需完整模拟全天 24 小时(日出清晨金色斜射 -> 正午直射白色高光 -> 傍晚日落漫反射橙红余晖 -> 夜晚幽蓝月光与底座泛光)的动态衰减。同时碑身细节与题词需要精准还原。
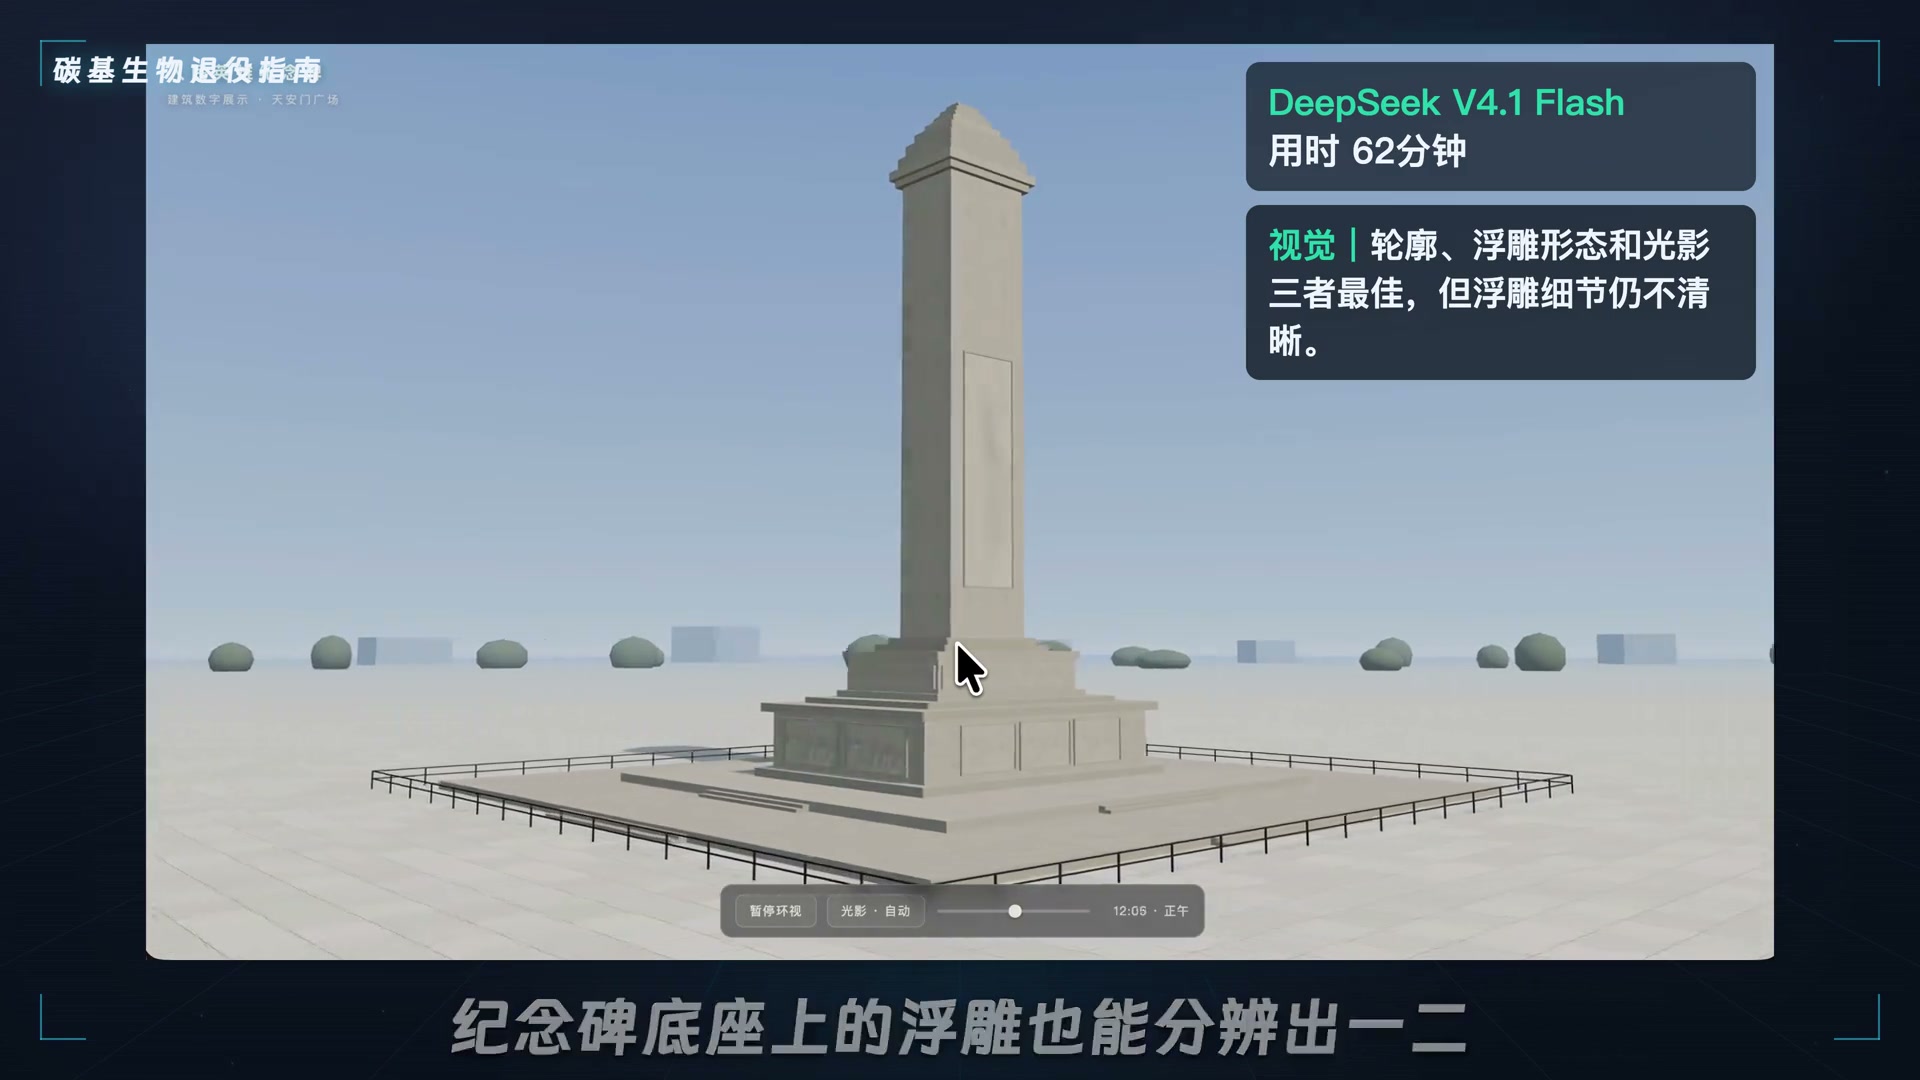
图 5:3D 智能体编码实测:DeepSeek 视觉效果技惊四座,但排队耗时长达 1 小时
三方编码表现全景复盘:
| 测评模型 | 实测耗时 | 视觉呈现与几何精度 | 代码工程规范度 | 关键缺陷 / 闪光点 |
|---|---|---|---|---|
| GPT-6 Luna | 7分15秒 | 中等 (光影平淡) | 极高 (模块化清晰) | 唯一生成了毛主席题词,但把竖排题词错搞成了横排 |
| Claude Haiku 5.5 | 8分23秒 | 最差 (碑身几何扭曲) | 良好 (参数集中化) | 日落日照色温符合现实,但碑身建模粗糙失真严重 |
| DeepSeek V4.1 Flash | > 60 分钟! | 全场断崖第一 | 高级封装性能优化 | 底座十幅汉白玉浮雕轮廓惊艳!但晚高峰排队让人抓狂 |
1. GPT-6 Luna 的表现: 代码质量极其规范,严格遵循了 ES6 Module 规范,将 CameraController、SunCycleShader 和 MonumentGeometry 清晰拆分,非常易于后续前端工程师二次维护。更难能可贵的是,它是唯一一个细心通过 Canvas 贴图生成了“人民英雄永垂不朽”题词的模型,遗憾的是把中国传统竖排书法错误渲染成了现代横排。
2. Claude Haiku 5.5 的表现: 视觉效果在三者中垫底。尽管天幕颜色过渡较为柔和,但碑身底座的长宽比例严重失调,甚至出现了网格穿模。这印证了一个行业经典定律:在参数规模受限的轻量模型中,语言与修辞神经元占用较多的模型,其 3D 几何拓扑空间理解力往往较弱。
3. DeepSeek V4.1 的震撼与尴尬: 当最终页面渲染出来时,全场为之惊艳——DeepSeek 不仅把主碑、须弥座、双层汉白玉栏杆完美还原,甚至利用程序化法线贴图(Procedural Normal Map)模拟出了底座浮雕的立体阴影感!然而,其致命死穴是:在晚上 9 点以后的服务器低谷时段,生成这个任务竟然足足消耗了一个多小时! 高并发下的排队延迟严重削弱了工业可用性。
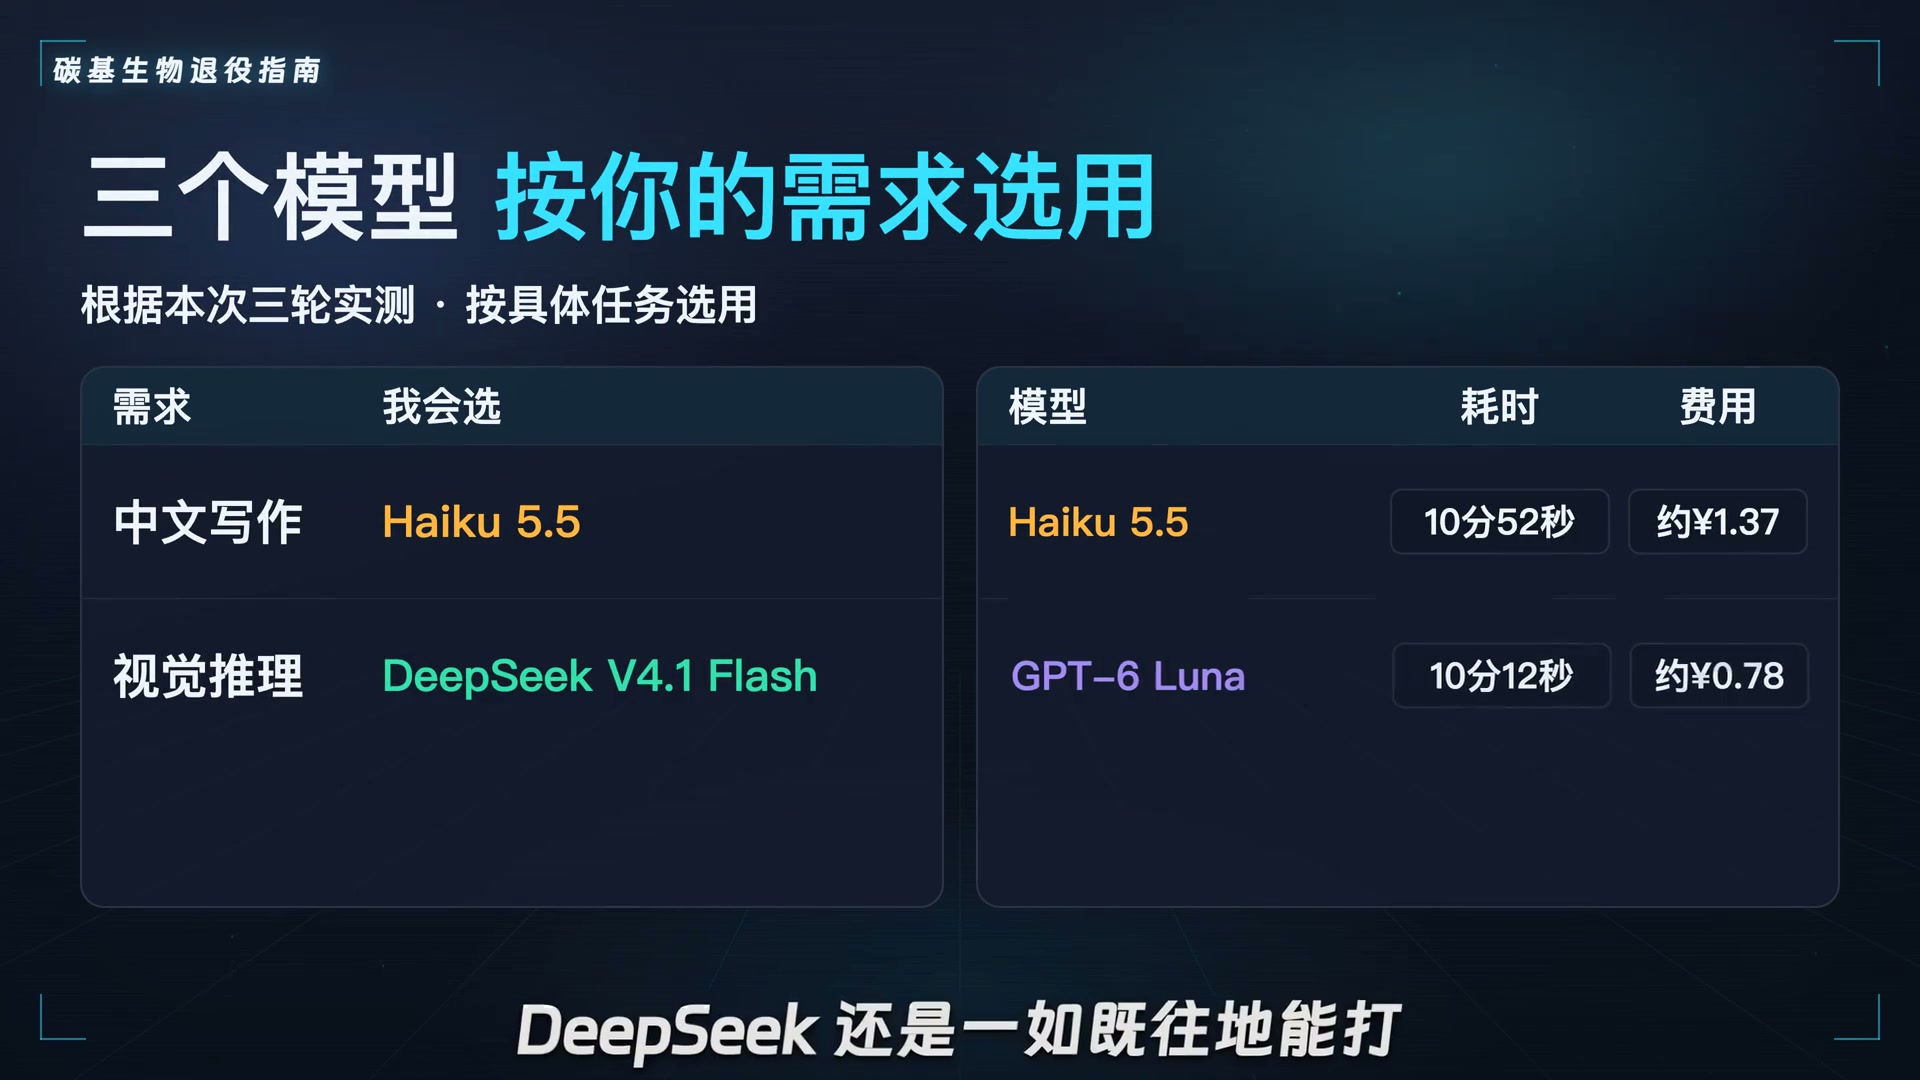
图 6:三款轻量大模型全景评测总结盘点
五、工业级落地:Multi-Agent 混合智能体路由实操架构
通过以上实测,可以得出一个非常清晰的工业级选型结论:在 2026 年的企业生产环境中,试图“单吊某一个模型解决所有任务”是极度业余的做法!
最聪明的架构方案,是构建一个智能请求路由调度器(Intelligent Multi-Agent Router):
- Claude Haiku 5.5 负责: 前置意图识别、中文用户沟通、市井感文案润色、短上下文(<100K)的即时对话;
- GPT-6 Luna 负责: 日常代码生成、逻辑校验、数据格式标准化与对延迟敏感的 API 工作流;
- DeepSeek V4.1 Flash 负责: 复杂的图像视觉解析、地狱级票据审计、3D/数学离线复杂计算(异步任务队列处理)。
以下是具备Token 阶梯熔断与并发超时 Fallback特性的 Python 生产级路由代码示例:
# -*- coding: utf-8 -*-
"""
Multi-Agent Production Router with Cost-Guard and Timeout Fallback
Designed for Haiku 5.5, GPT-6 Luna, and DeepSeek
"""
import time
from typing import Dict, Any

class HybridAgentRouter:
    def __init__(self):
        self.HAIKU_MAX_SAFE_TOKENS = 95_000  # 规避 100K 5倍价格阶梯刺客
        self.DEEPSEEK_TIMEOUT_SEC = 25.0     # 针对排队延迟的超时熔断

    def estimate_tokens(self, prompt: str) -> int:
        # 简单中英文混排 Token 估算
        return int(len(prompt) * 0.85)

    def route_request(self, task_type: str, prompt: str, images: list = None) -> Dict[str, Any]:
        token_count = self.estimate_tokens(prompt)

        # 路由策略 1: 复杂视觉多模态单据
        if images and len(images) > 0:
            print(f"[Router] 命中多模态视觉审计任务 ({len(images)} 张图片)")
            return {
                "primary_model": "deepseek-v4.1-flash",
                "fallback_model": "claude-haiku-5.5",
                "timeout": 45.0,
                "reason": "DeepSeek 票据与视觉推理精度与性价比最优,超时回退至 Haiku 5.5"
            }

        # 路由策略 2: 中文文学润色与人设对话
        if task_type in ["copywriting", "dialogue", "creative_writing"]:
            # 必须检查是否触碰 100K 价格刺客
            if token_count <= self.HAIKU_MAX_SAFE_TOKENS:
                return {
                    "primary_model": "claude-haiku-5.5",
                    "fallback_model": "gpt-6-luna",
                    "timeout": 15.0,
                    "reason": "Haiku 5.5 中文长文自然度极高且处于低单价区间"
                }
            else:
                return {
                    "primary_model": "gpt-6-luna",
                    "fallback_model": "deepseek-v4.1-flash",
                    "timeout": 20.0,
                    "reason": "Token 超过 100K 安全阈值,绕开 Haiku 5倍阶梯暴涨"
                }

        # 路由策略 3: 标准编程与代码维护
        if task_type in ["coding", "refactor", "tool_use"]:
            return {
                "primary_model": "gpt-6-luna",
                "fallback_model": "claude-haiku-5.5",
                "timeout": 20.0,
                "reason": "GPT-6 Luna 代码架构模块化规范,兼具稳定低延迟"
            }

        # 默认常规通道
        return {"primary_model": "gpt-6-luna", "fallback_model": "deepseek-v4.1-flash", "timeout": 20.0}

# 实例化路由器
router = HybridAgentRouter()
dispatch = router.route_request("creative_writing", "请为修真小说撰写第一章...", images=[])
print(f"推荐执行节点: {dispatch['primary_model']} (Rationale: {dispatch['reason']})")
六、总结与选型决策指南
一场横评下来,三大轻量级模型各有千秋:
- Claude Haiku 5.5: 适合文字敏感型产品(客服情感抚慰、文案创作、短文档抽取),是目前最不像 AI 的轻量级模型。但请时刻盯紧你的 Token 消耗,避免 100K 以上的 5 倍费用反噬。
- GPT-6 Luna: 适合作为企业 Agent 的主干劳动力(Worker Node)。虽然文学水平中庸,但逻辑与代码模块化极为扎实,计费平稳无坑。
- DeepSeek V4.1 Flash: 性价比与视觉天花板。如果官方能持续增加算力基础设施,彻底解决高峰期与复杂任务排队延迟问题,它将是整个大模型市场最具威胁的颠覆者。
- 🌐 开发者 IP 纯净度与大模型风控体检中心(测住宅/机房节点与 Anthropic / OpenAI 封号风险)
- 🇺🇸 多国随机地址与美国免税州生成器(精准匹配 0% 消费税免税州,解决海外升级税费)
- 🔑 在线 2FA 动态验证码生成工具(网页直接提取 6 位 TOTP 动态码,安全脱机)
- ⚡ 开发者实用工具箱(免费下载 Cursor 机器码重置等实用脚本)
- 🛒 链动小铺官方现货自营店(ChatGPT Plus、Claude、Pro 独享现货)