【2026独家硬核实测】GPT-6 Astra 独门秘籍:一个开关激活中途动态推理并锁定 Prompt Cache!从 91% 飙升至 95.6% 缓存命中的配置全解
导读与痛点直击: 很多开发者升级到 OpenAI 最新的 GPT-6 Astra 旗舰全家桶后,常抱怨 5 小时动态额度与每周 Token 限额跑得极快。殊不知,官方在发布 GPT-6 Astra 时悄然上线了一项底层杀手锏能力——「允许在对话推理中途无损调整思考强度,且完好保留 Prompt Cache」!然而,Codex 桌面端订阅用户默认并没有开启该项特性。本文详解如何在 config.toml 中添加一行核心配置,实测在同一复杂任务中将缓存命中率从 91.0% 提升至 95.6%,大幅节省 Token 额度并消除重复等待!
一、官网技术原理解读:Astra 独家新特性的冰山之下
随着 OpenAI GPT-6 Astra 的全面实装,官方文档在 What's new 章节披露了数项革命性更新:
- Async tool calling(异步工具调用): 模型在宿主应用执行工具(例如跑终端命令或长耗时脚本)期间,可以继续并发思考、调用其他独立工具,无需原地阻塞。
- Mid-turn steering(中途追加指令/转向): 基于 WebSocket 长连接的双向流式传输,允许用户在模型还在输出甚至深度思考时中途插入补充要求或纠偏指令,模型无缝吸收并生成续篇。
- Change reasoning mid-conversation while preserving cache(对话中途切换推理强度并保留缓存): 这是 Astra 最具杀伤力却最易被忽略的独享能力! 开发者无需为了切换思考深度而重新组织 Prompt,直接在对话推进中调大或调小思考强度,历史上下文的 Prompt Cache 毫发无损!
- Misalignment monitoring(目标偏离与安全性异步监控): 异步守护模型输出方向,防止 Agent 陷入死循环或越权操作。
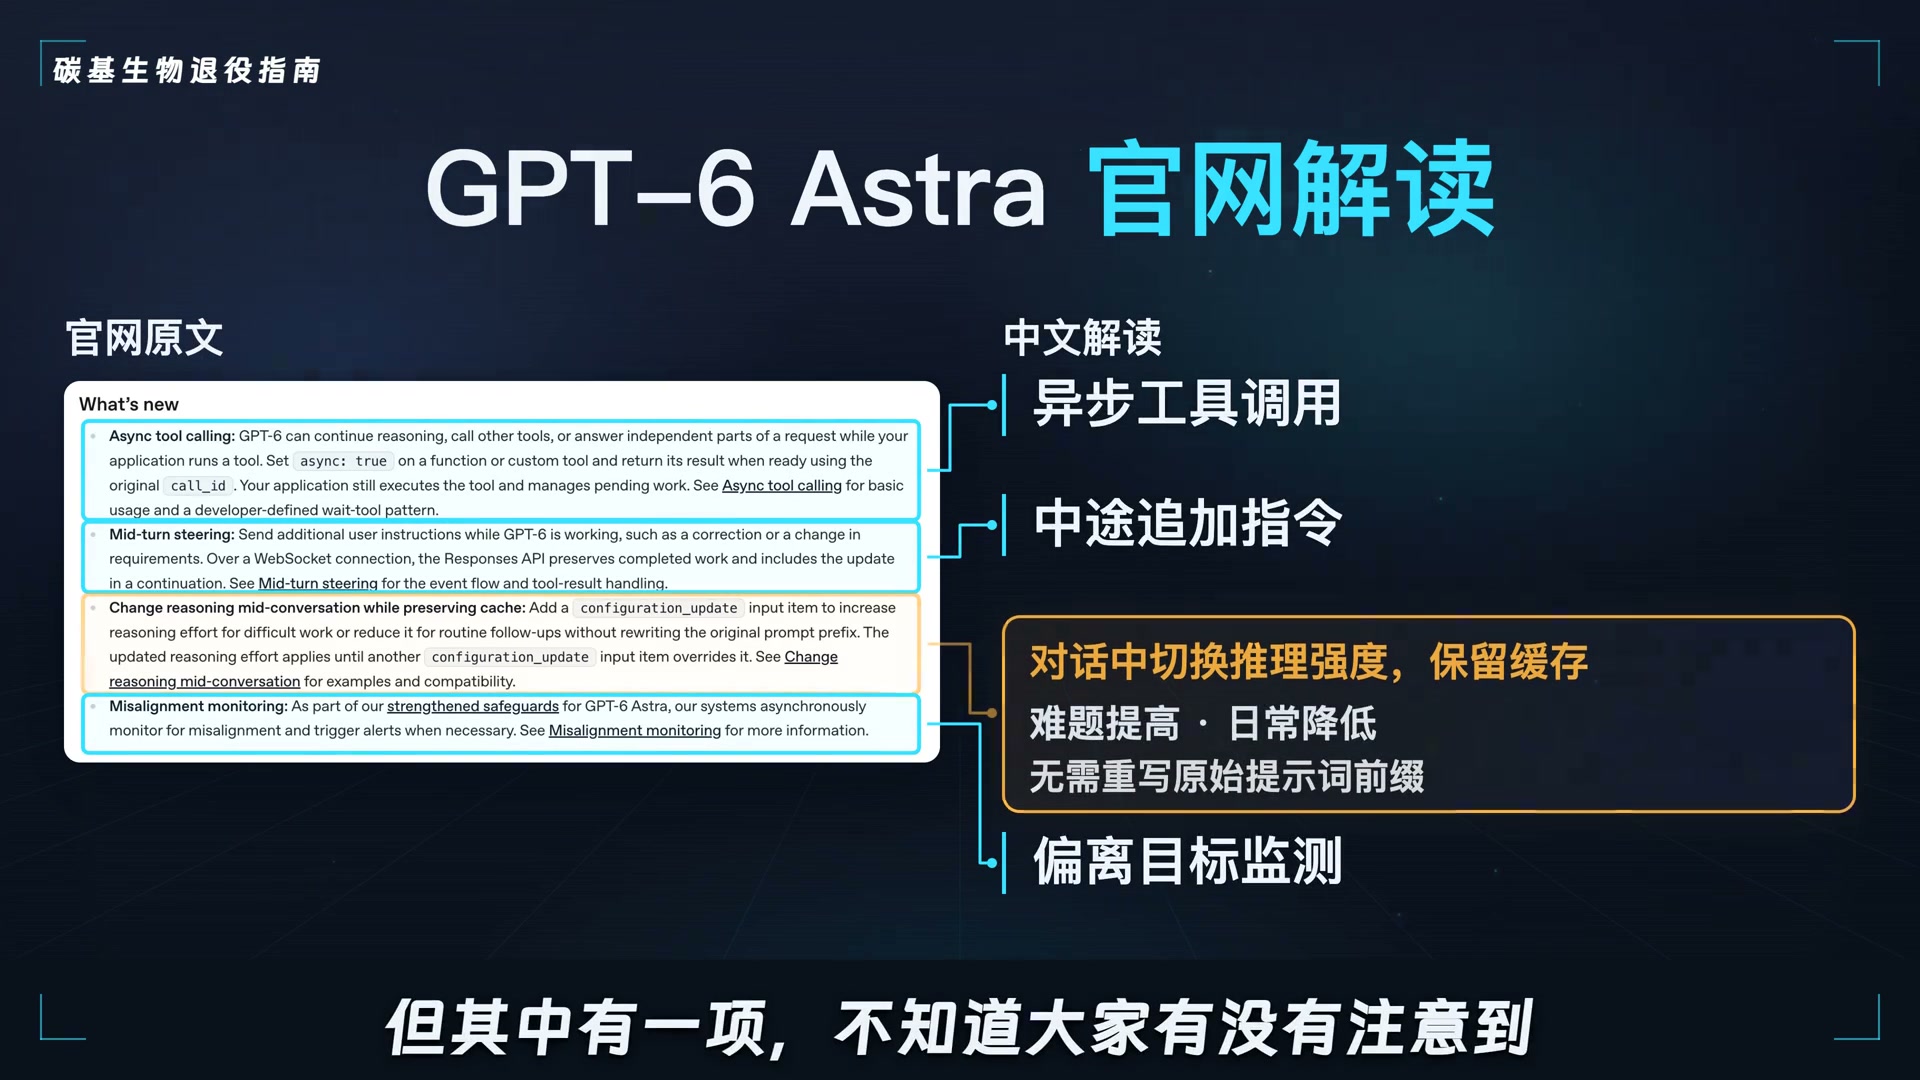
图 1:OpenAI 官方文档对 Astra 动态推理强度与保留缓存的权威技术界定
在大语言模型的 Prompt Caching(如 OpenAI / Anthropic 的前缀缓存)机制中,缓存命中极其严苛地遵循 Prefix Matching(前缀严格匹配原则)。在过去的 o1、o3 或旧版模型中,reasoning_effort(推理强度)是作为全局请求级参数传入的。如果在多轮长对话中,前一轮是 low,你突然想改用 high 攻坚难点,整段请求的元数据签名便会改变,直接导致已缓存的数万 Token KV Cache 瞬间穿透,所有历史前缀全部按高昂的全额输入 Token 重新计费!
二、桌面端订阅用户的困境:为什么默认没有开启?
对于直接使用 OpenAI 官方 API 的开发者,可以通过在输入项中追加 configuration_update 实现动态推理强度切换。但绝大多数订阅了 ChatGPT Plus / Pro / Team 的开发者,主力生产力工具是 Codex 桌面客户端。
在 Codex 桌面版中,OpenAI 默认将此功能隐藏在实验性 Feature Flag 之后,UI 界面上并没有公开的勾选按钮。这导致订阅用户在复杂项目中,如果中途想调大思考深度,往往只能新开会话或者忍受重复计费与配额急速衰减。
好消息是,Codex 官方团队其实在底层保留了用户级控制开关,只需在配置文件中激活即可!
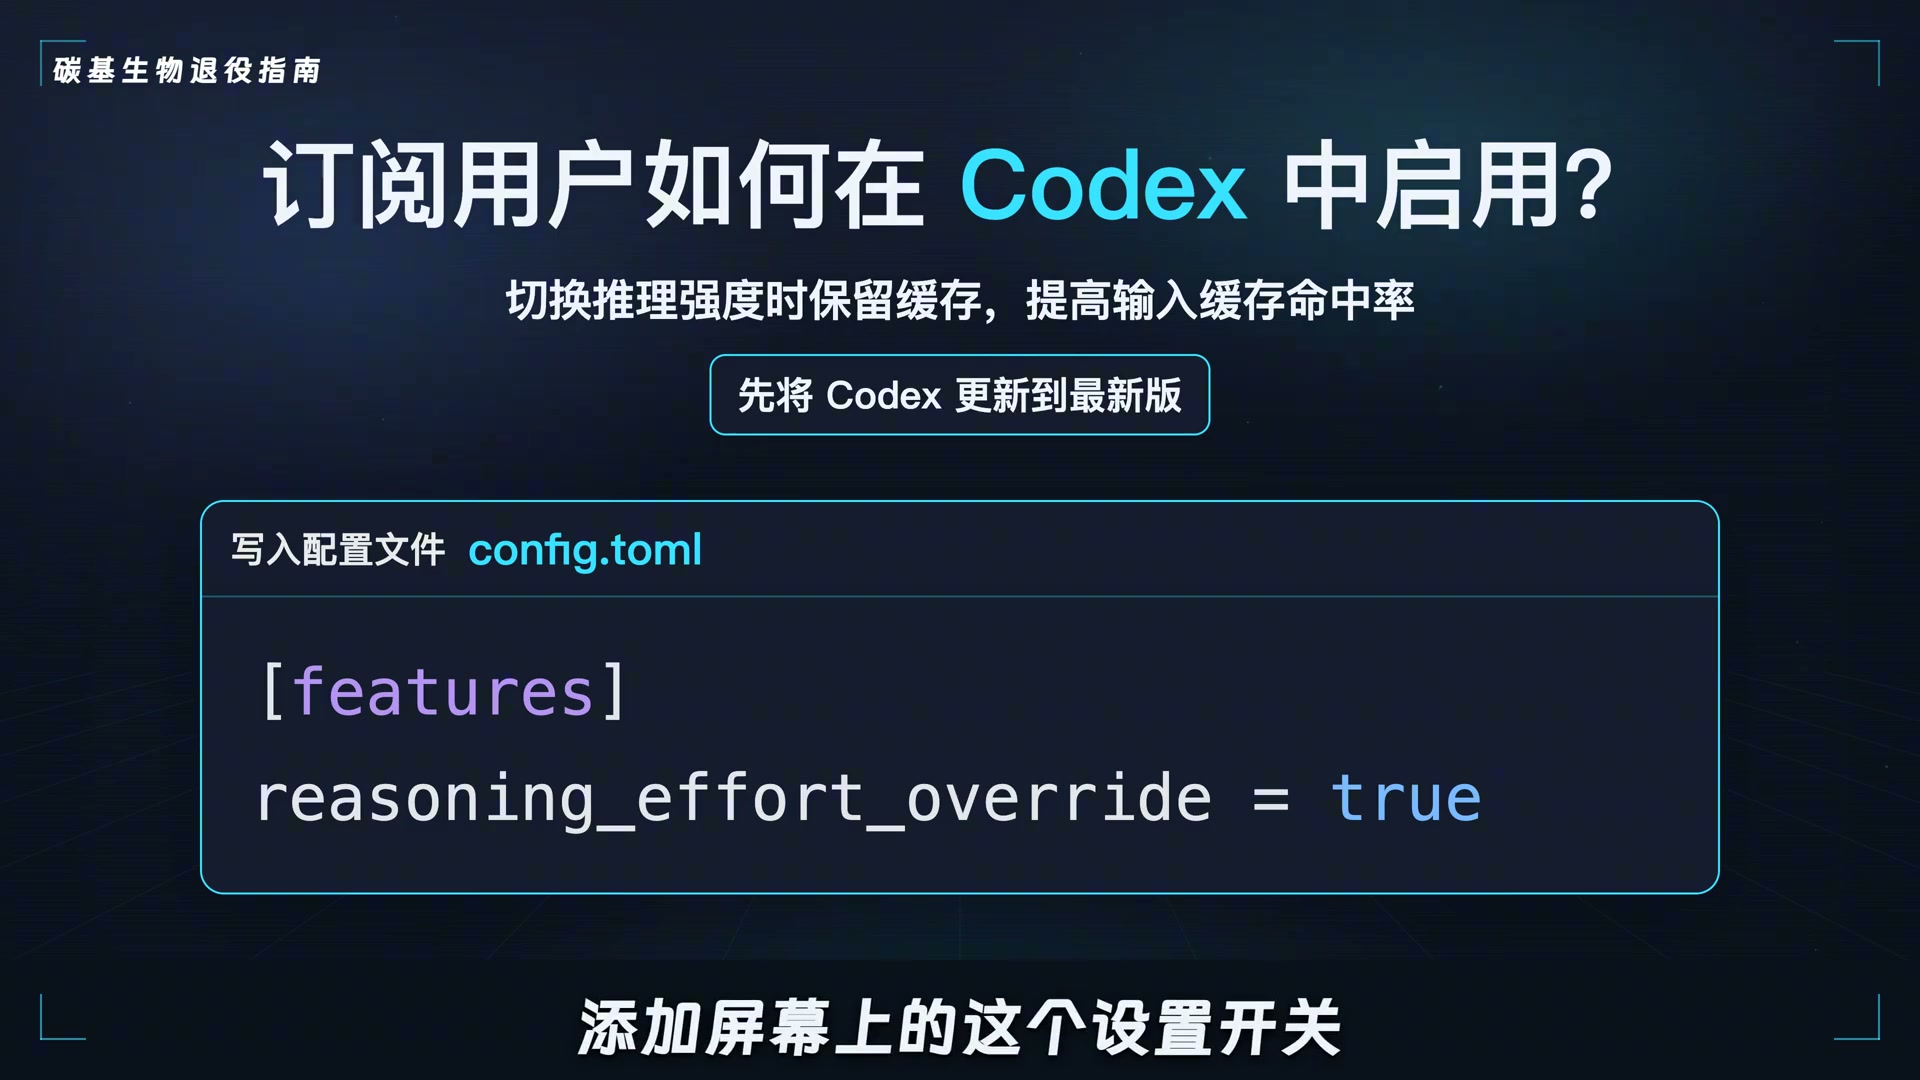
图 2:Codex 桌面端订阅用户启用动态推理保留缓存的核心配置项
三、手把手实操:一个开关激活隐藏神技
操作非常简单清晰,请按照以下三个规范步骤进行配置:
步骤 1:确认 Codex 客户端升级到最新版本
请确保你的 Codex 桌面客户端或 CLI 工具已升级至支持 Astra 动态配置协议的最新构建(建议 2026 年 9 月下旬及以后的最新 Release 版本)。旧版本缺少对 configuration_update 的协议支持,即使添加了配置也不会生效。
步骤 2:精准定位用户级 config.toml 配置文件
Codex 区分了用户全局配置(User-Level Config)与项目工作区配置(Workspace-Level Config)。为了让所有项目均能享受缓存保留红利,我们直接编辑用户全局配置文件:
- 通过 Codex 界面直达: 点击左下角 Settings(设置) → 选择 Configuration(配置) → 点击打开「User config.toml」。
- 或者直接打开本地目录路径:
- Windows:
%USERPROFILE%\.codex\config.toml(例如C:\Users\YourUsername\.codex\config.toml) - macOS:
~/.codex/config.toml - Linux:
~/.config/codex/config.toml或~/.codex/config.toml
- Windows:
步骤 3:写入 reasoning_effort_override = true
在打开的 config.toml 中,找到 [features] 小节(如果没有则新建)。添加如下行:
[features]
reasoning_effort_override = true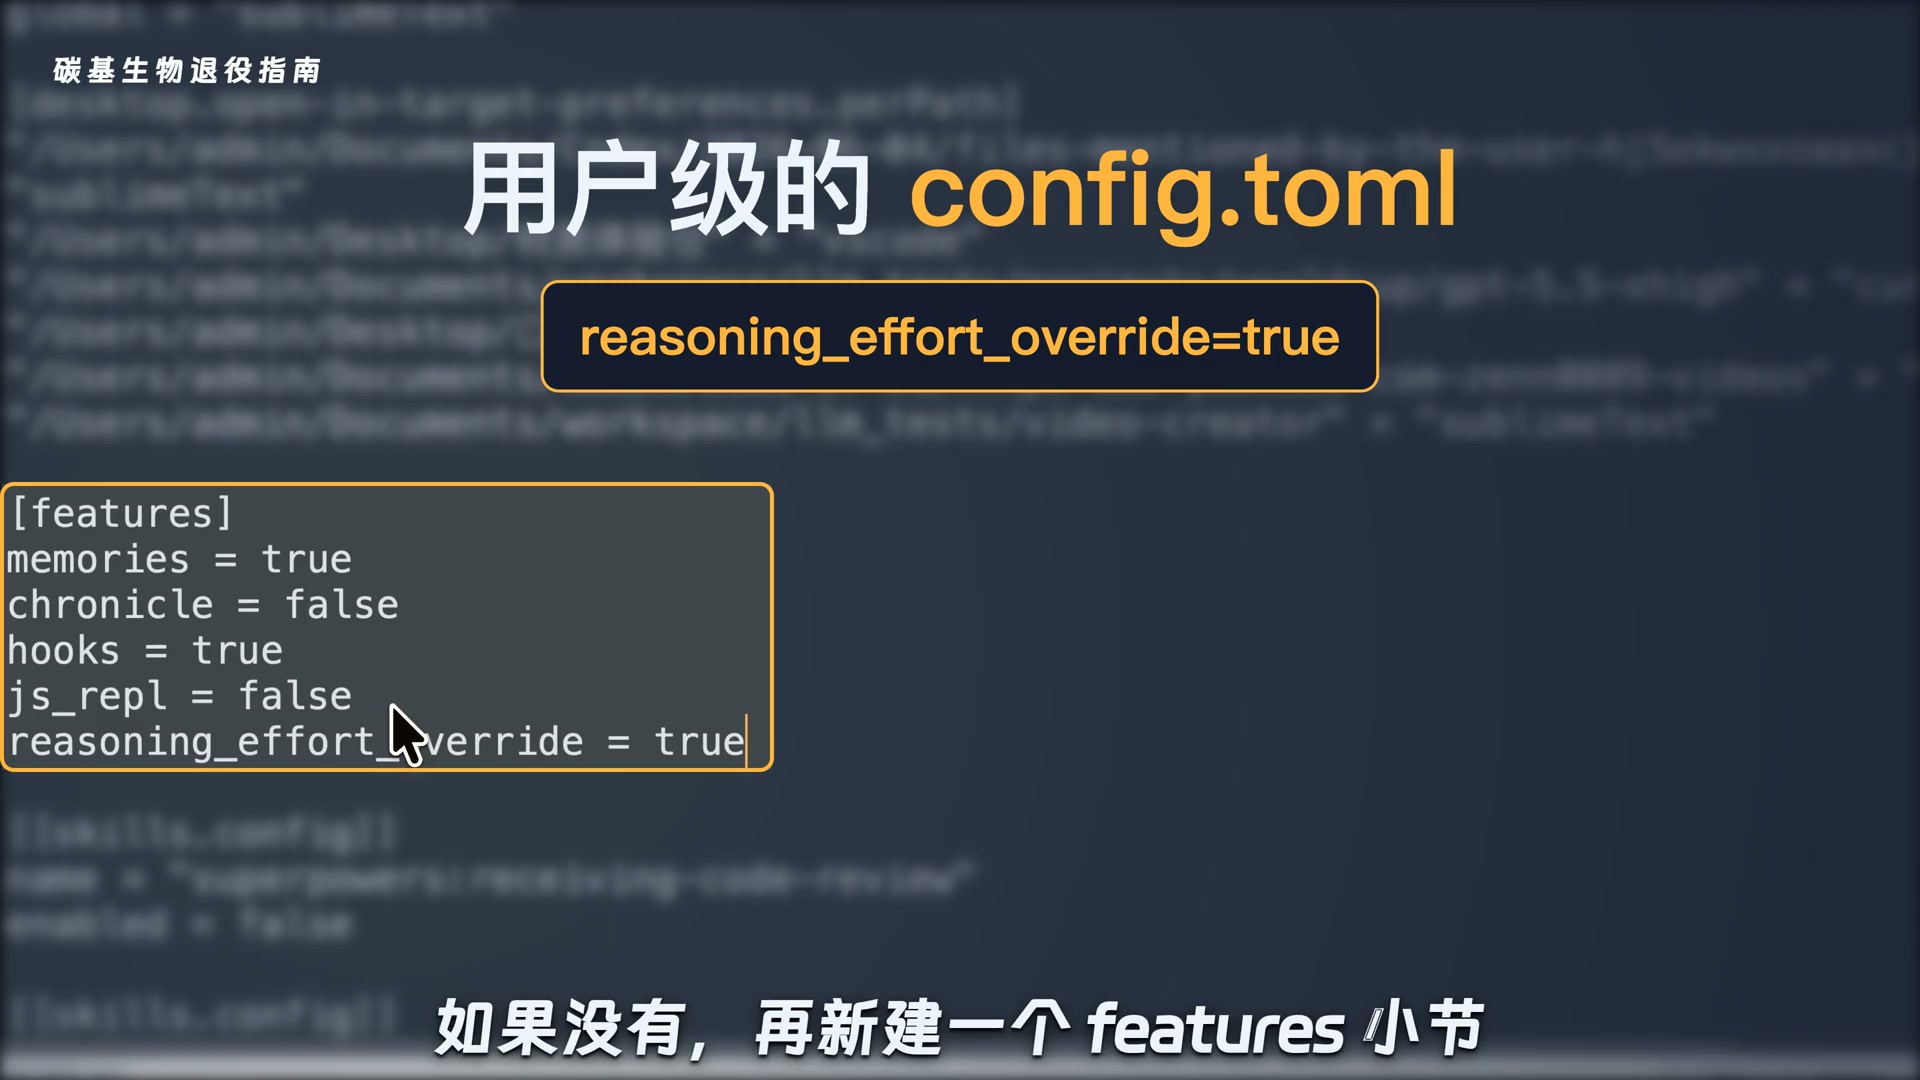
图 3:在用户级 config.toml 的 [features] 节点中补全配置项
TOML 配置文件具有强语法约束:同一个配置文件内,[features] 标识只能出现一次!
如果你的配置文件中已经存在 [features](例如配置了 memories = true 或 hooks = true),切勿重复声明 [features],只需直接在现有的 [features] 区块下方追加 reasoning_effort_override = true 即可;否则会导致 TOML 解析失败报错!
四、真实任务实机跑分:同一任务对比,91.0% → 95.6% 飞跃!
配置完成后,我们以一个复杂多阶段的工程任务进行严格控制变量对比测试:「构建 2D Canvas 剪纸风格动画,包含多镜头调度、帧动画渲染与 Playwright 自动化回归验证」。
在任务执行过程中,我们从初始阶段的「轻度(Low)推理」,在中途遇到复杂的几何投影运算时手动拉高到「中度(Medium)」,在终验阶段直接调到「极高(High/Ultra)」。
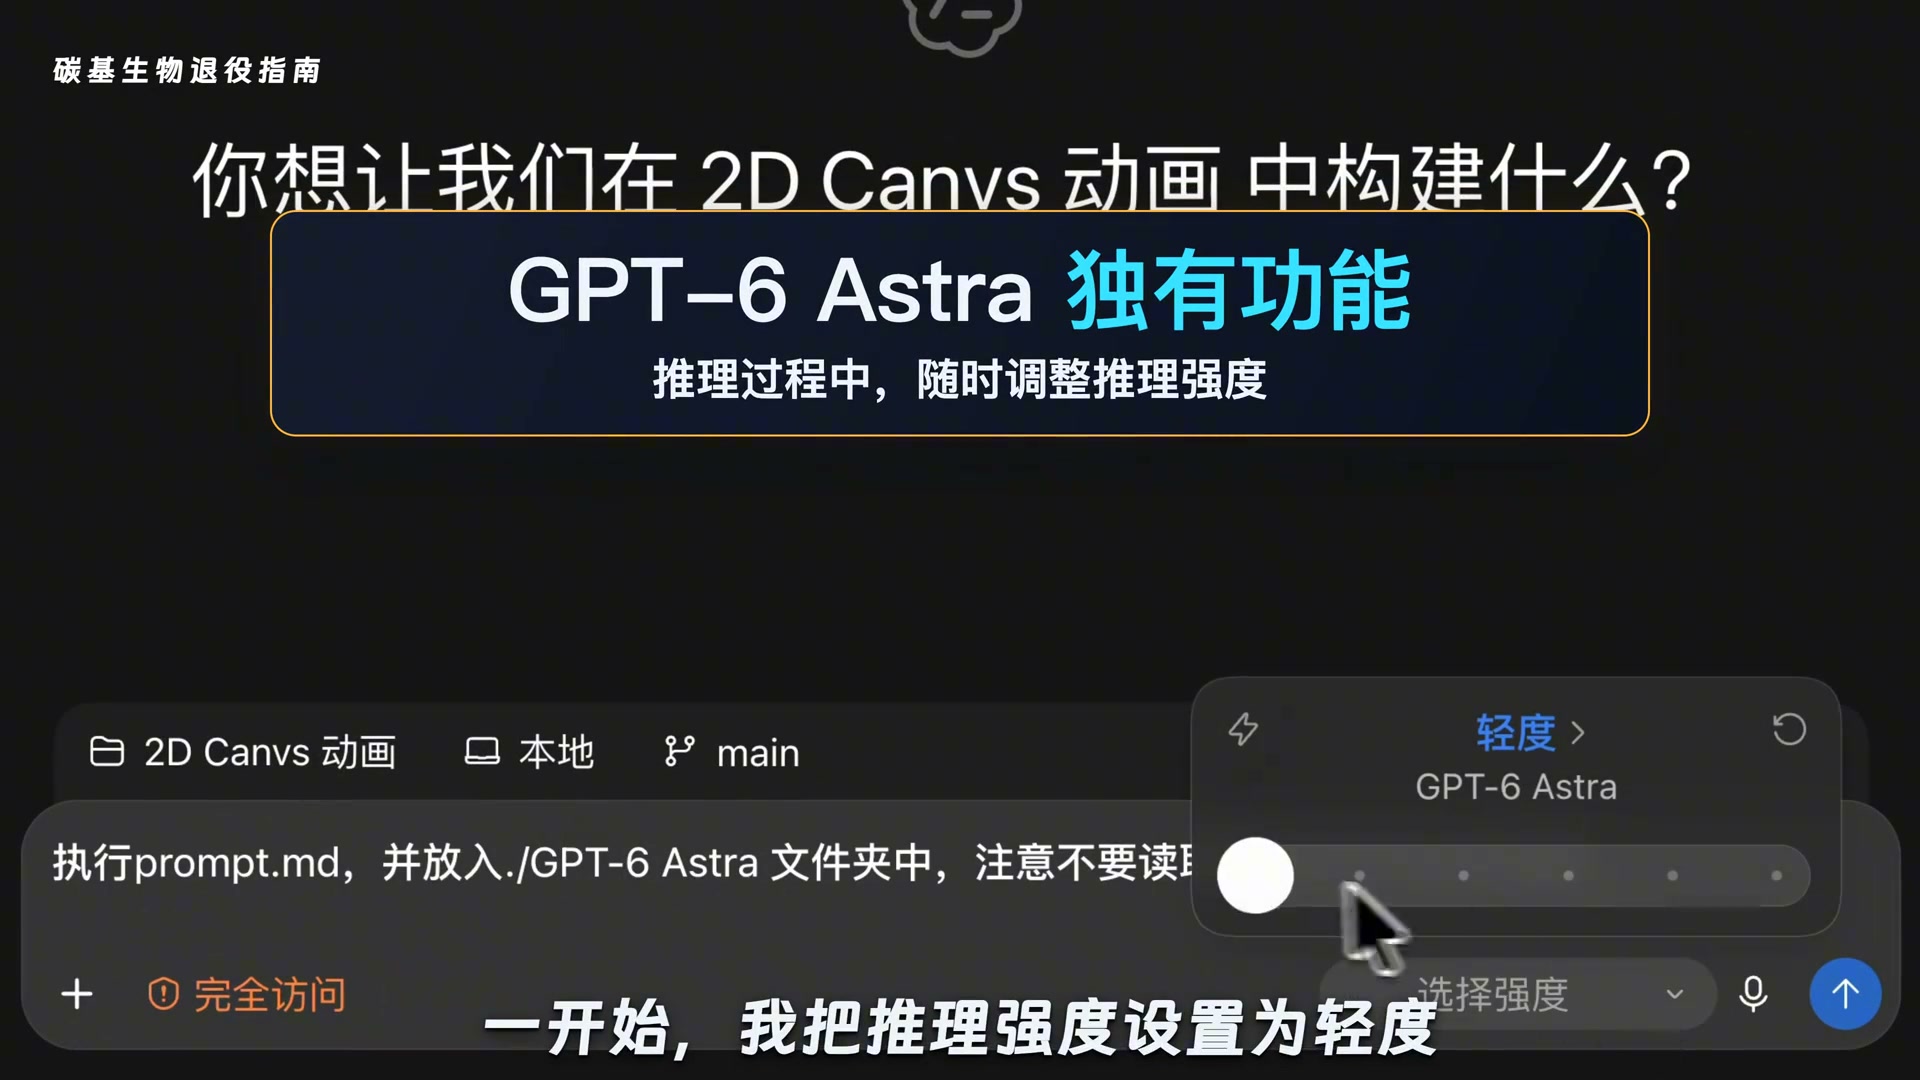
图 4:开启后在任务推进中随意切换推理强度,任务不中断,Astra 实时吸收并接管继续深度推导
我们使用用量分析监控工具,对「开启开关前」与「开启开关后」完全相同的任务流进行了精准的数据记录:
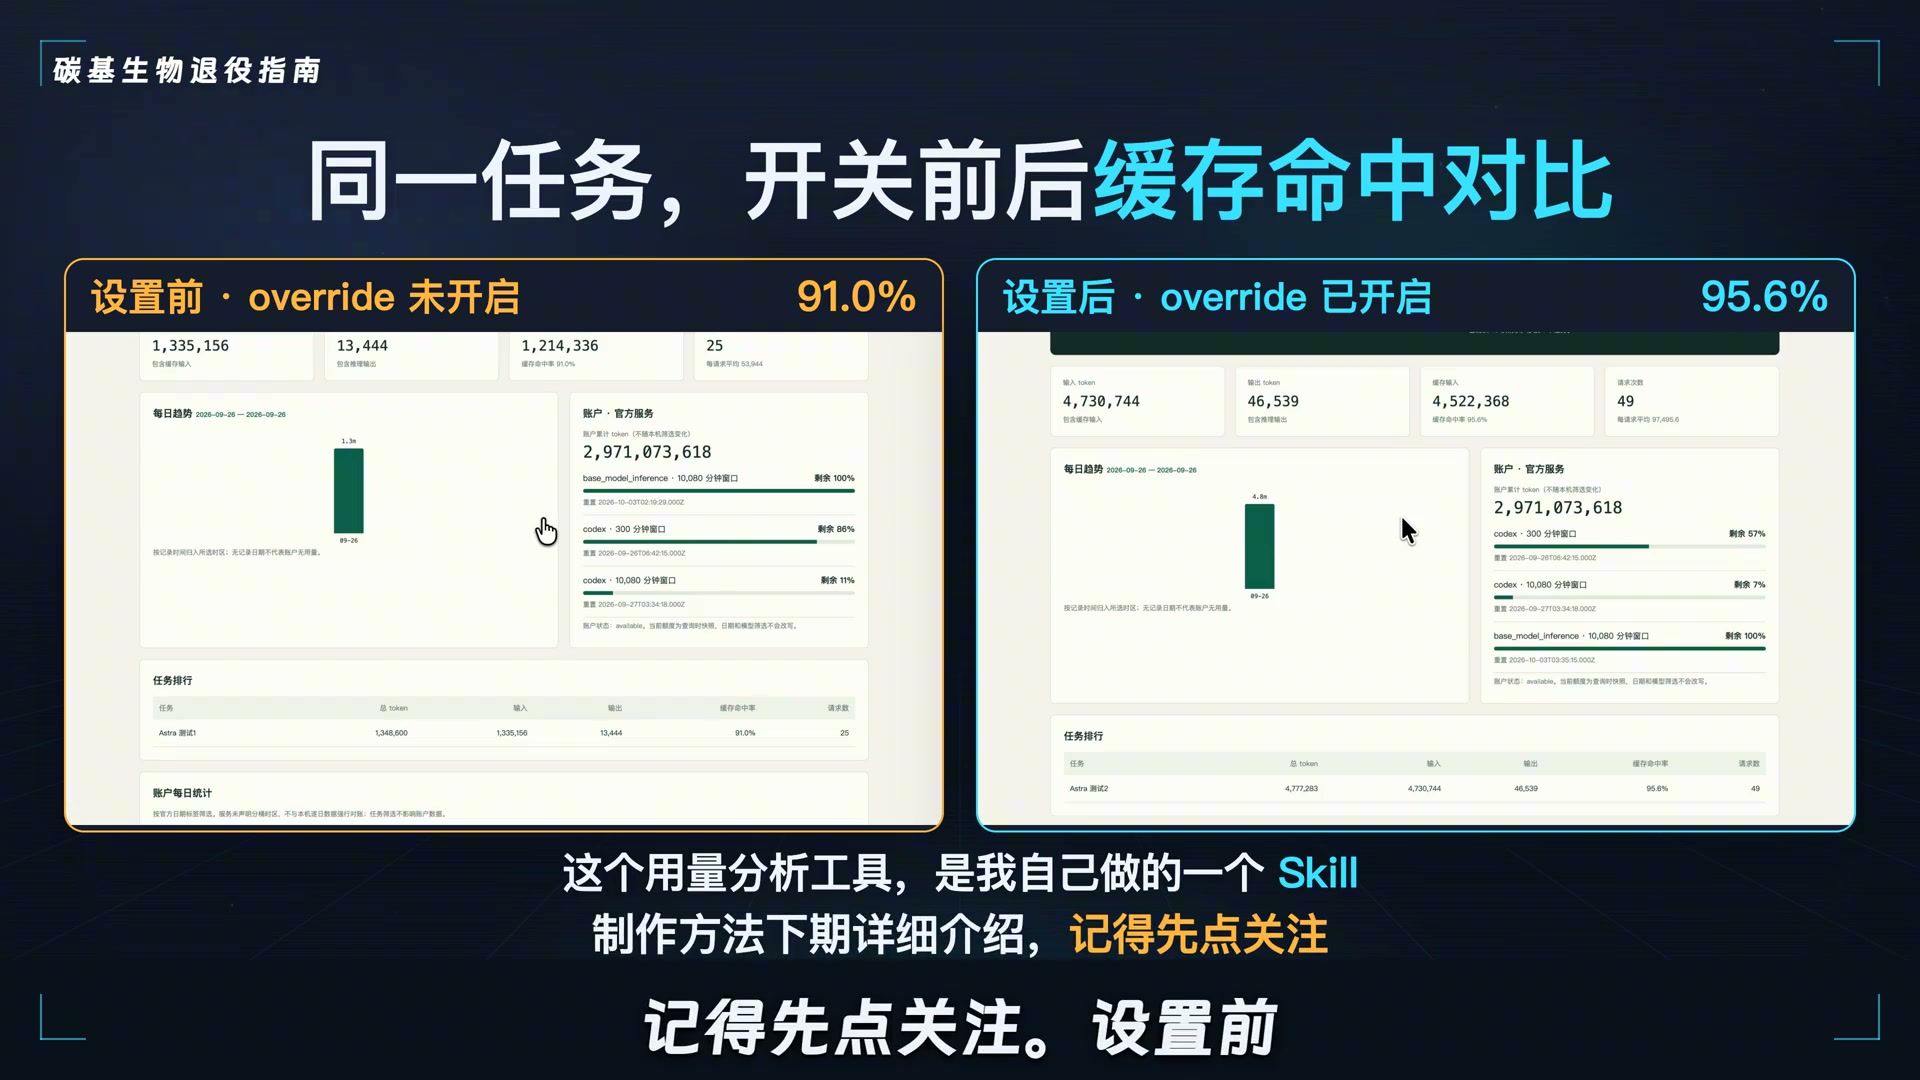
图 5:真实统计报告:设置前 91.0% vs 设置后 95.6% 输入缓存命中率对比
| 测试组别 | 总输入 Token | 缓存命中 Token | 缓存命中率 | 输出 Token | 配额保护效果 |
|---|---|---|---|---|---|
| 对照组(开关未开启) | 1,335,156 | 1,214,336 | 91.0% | 13,444 | 每次调参产生约 12 万非缓存惩罚 |
| 实验组(override 已开启) | 4,730,744 | 4,522,368 | 95.6% 🔥 | 46,539 | 多轮交互深度攻坚零损耗 |
配额经济学分析: 别小看从 91.0% 到 95.6% 这看似 4.6 个百分点的提升!对于动辄几百万 Token 的大型代码库重构或复杂长任务,未命中缓存的比例从 9.0% 骤降到 4.4%,相当于未命中惩罚直接砍半(下降了 51.1%)!这对于 Codex 用户的 300 分钟窗口和 10,080 分钟窗口的平滑续航,有着立竿见影的续命效果!
五、进阶 API 开发者落地指南:如何用代码实现动态下发?
如果你是在自己的后端应用、Agent 编排框架或私有网关中对接 GPT-6 Astra,官方建议使用新的 Responses WebSocket API 协议。核心逻辑是在维持同一 conversation_id 时,中途向流中发送 configuration_update:
// Node.js / TypeScript WebSocket API 示例
import WebSocket from 'ws';

const ws = new WebSocket('wss://api.openai.com/v1/responses', {
  headers: {
    'Authorization': `Bearer ${process.env.OPENAI_API_KEY}`,
    'OpenAI-Beta': 'responses=v1'
  }
});

ws.on('open', () => {
  // 1. 初始化对话任务,以 low 推理启动
  ws.send(JSON.stringify({
    type: 'response.create',
    model: 'gpt-6-astra',
    reasoning_effort: 'low',
    input: [
      { role: 'user', content: '分析当前项目结构并提出重构方案...' }
    ]
  }));
});

// 2. 当检测到需要深度逻辑攻坚或遇到死循环时,动态提升推理强度而不丢缓存
function boostReasoningEffort(targetEffort = 'high') {
  ws.send(JSON.stringify({
    type: 'response.input_item.create',
    item: {
      type: 'configuration_update',
      reasoning_effort: targetEffort // 动态生效直至下一条 override 指令
    }
  }));
  console.log(`[Astra] Reasoning effort successfully elevated to: ${targetEffort}`);
}
六、总结与开发者实战建议
- 立即配置: 打开你的
~/.codex/config.toml,添加reasoning_effort_override = true。一行代码,永久享受 Astra 缓存保留红利。 - 动态调节心法: 遇常规代码解释、格式转换使用「轻度」节省时间;遇并发死锁排查、架构设计拉到「高」或「极高」集中算力;中途无缝切换,绝不浪费宝贵配额。
- 风控与网络保障: GPT-6 级服务对网络风控极其敏感,频繁在机房脏节点切换容易触发账号降级或封控。建议使用高纯净度原生家庭住宅节点,并通过本站的 IP 纯净度体检中心 随时检测欺诈分值。
- 🌐 开发者 IP 纯净度与大模型风控体检中心(测住宅/机房节点与防封分)
- 🇺🇸 多国随机地址与美国免税州生成器(精准匹配 0% 消费税免税州,解决海外升级税费)
- 🔑 在线 2FA 动态验证码生成工具(网页直接提取 6 位 TOTP 动态码,安全脱机)
- ⚡ 开发者实用工具箱(免费下载 Cursor 机器码重置等实用脚本)
- 🛒 链动小铺官方现货自营店(ChatGPT Plus、Pro 独享现货)