2026 年视觉 AI 迎来里程碑级跨越!阿里开源的 Qwen Image 2.1(通义千问图像大模型 2.1) 以惊艳的生成质感、精细的文字渲染以及前所未有的语义理解能力,被全球 AI 创作者公认为“当前开源综合能力最强的文生图与图像编辑一体化模型”!
更颠覆的是:过去我们需要在 SDXL、FLUX、Inpainting、Matting 抠图等十几个独立插件和工作流之间来回倒腾,而现在只需要一个 ComfyUI 工作流,即可无缝搞定文生图、反推洗图、抠图去背景、画圈编辑、无缝扩图与千万像素高清修复!
一、 为什么 Qwen Image 2.1 堪称“开源最强”?三大技术质变
相比于传统的扩散模型(Diffusion),Qwen Image 2.1 在多模态原生架构上实现了根本性突破:
- 双模型协同架构(T2I + I2I + VQA 提示词优化):官方原生拆分为
Text2Image (T2I)纯文生图主模型与Image2Image (I2I)图像编辑主模型,配合内置的视觉理解小模型,能够自动将几句含糊的人类语言在 5~8 秒内扩写为大模型最容易理解的高维结构化 Prompt; - 汉字与中英双语文字排版零错别字:彻底告别以往生成汉字“乱码鬼画符”的历史,海报文字、店招招牌、复杂排版完全精准直出;
- 无缝消除“像素偏移(Pixel Shift)”:图像编辑中最令人头疼的是改一件衣服导致整个人物面部微移变形。Qwen Image 2.1 在 32 整数倍空间尺寸对齐与局部遮罩传导下,实现了真正的零像素偏移!
二、 10 大核心实战场景能力全景拆解(一个工作流搞定)
🎨 1. 纯文生图 (Text-to-Image)
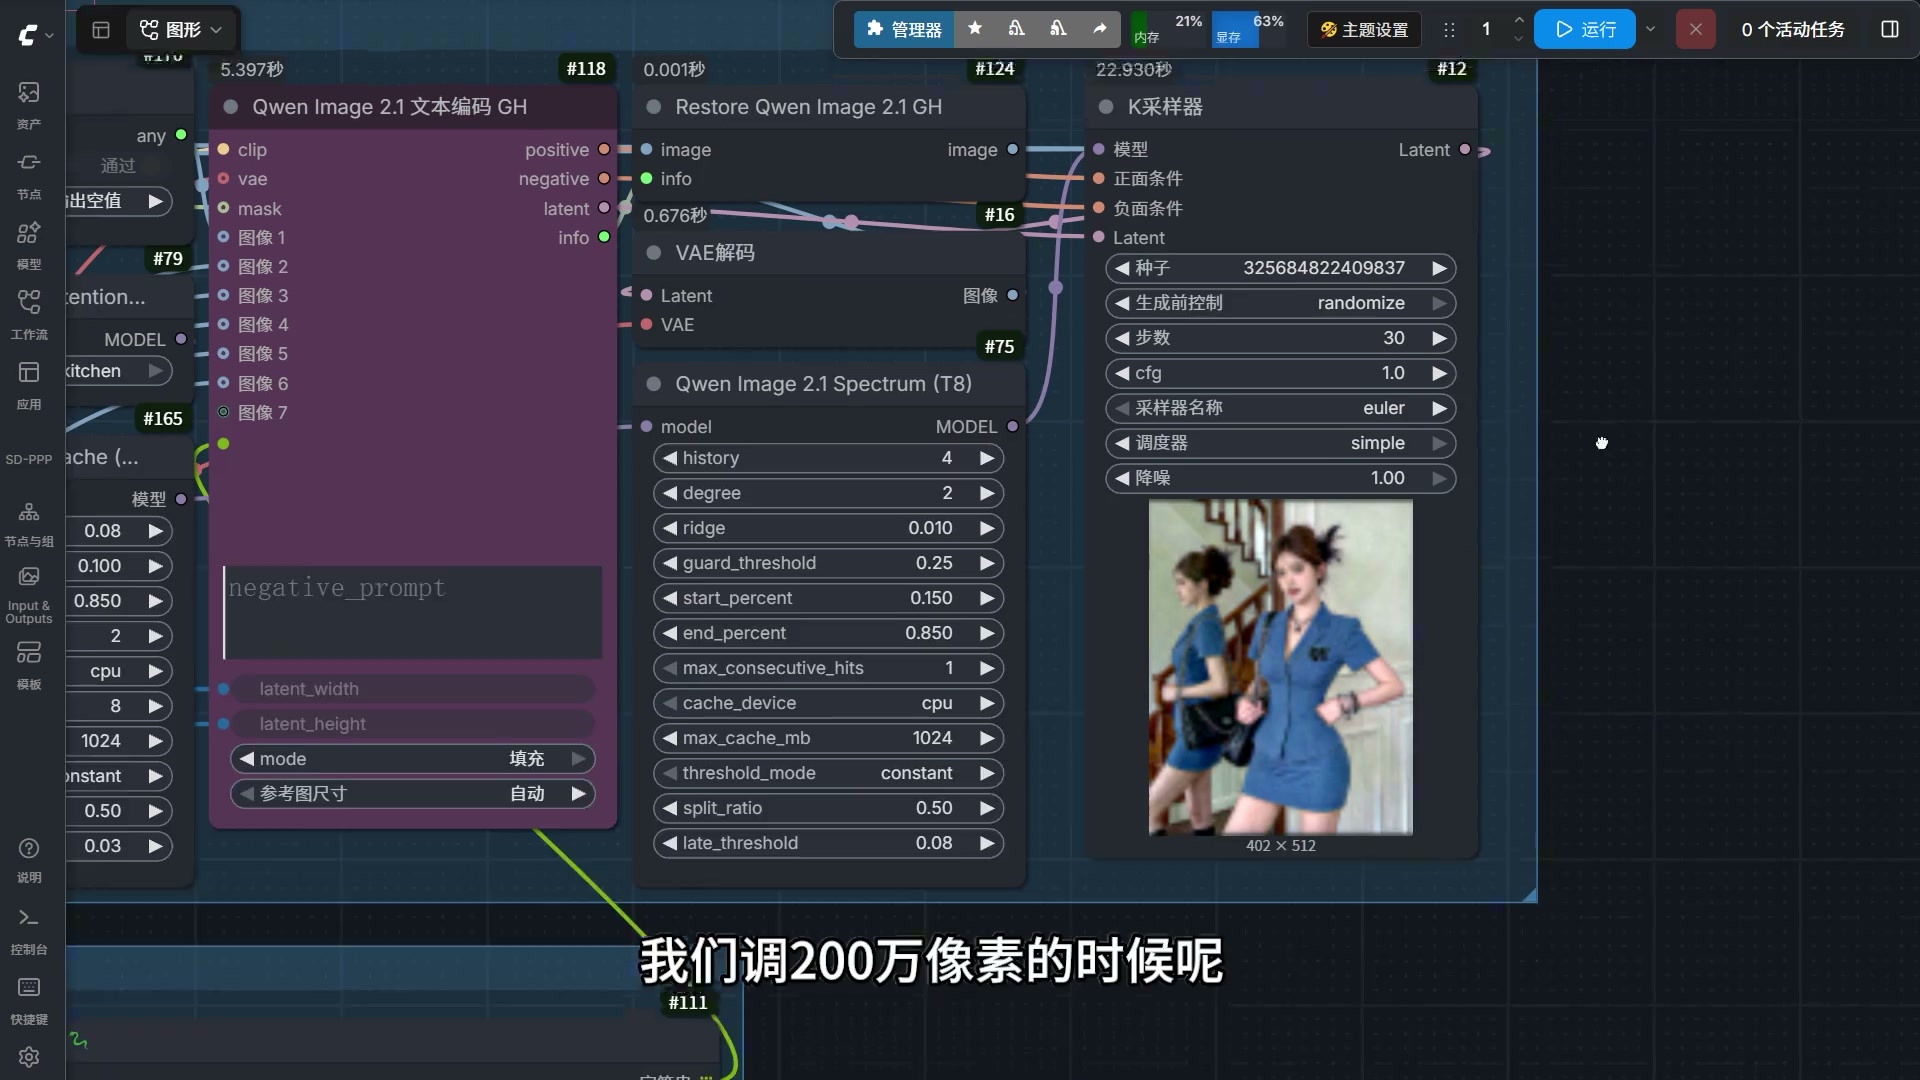
关闭所有图片开关即刻切换为文生图模式。支持自定比例(1:1、2:3、16:9 等)与像素总数(200万到 1000 万自由调节)。即使提示词留空,AI 也能自动发散生成极具质感的静物与艺术场景。
🔄 2. 反推洗图与复刻 (Prompt Reverse)
遇到喜欢的参考图,直接上传至图1且提示词留空。内置视觉模型自动分析构图、光影与元素,反推并生成同风格、全新构图的高清大片,完美保留原作精髓。
👔 3. 单图精准重绘与换装 (Inpainting)
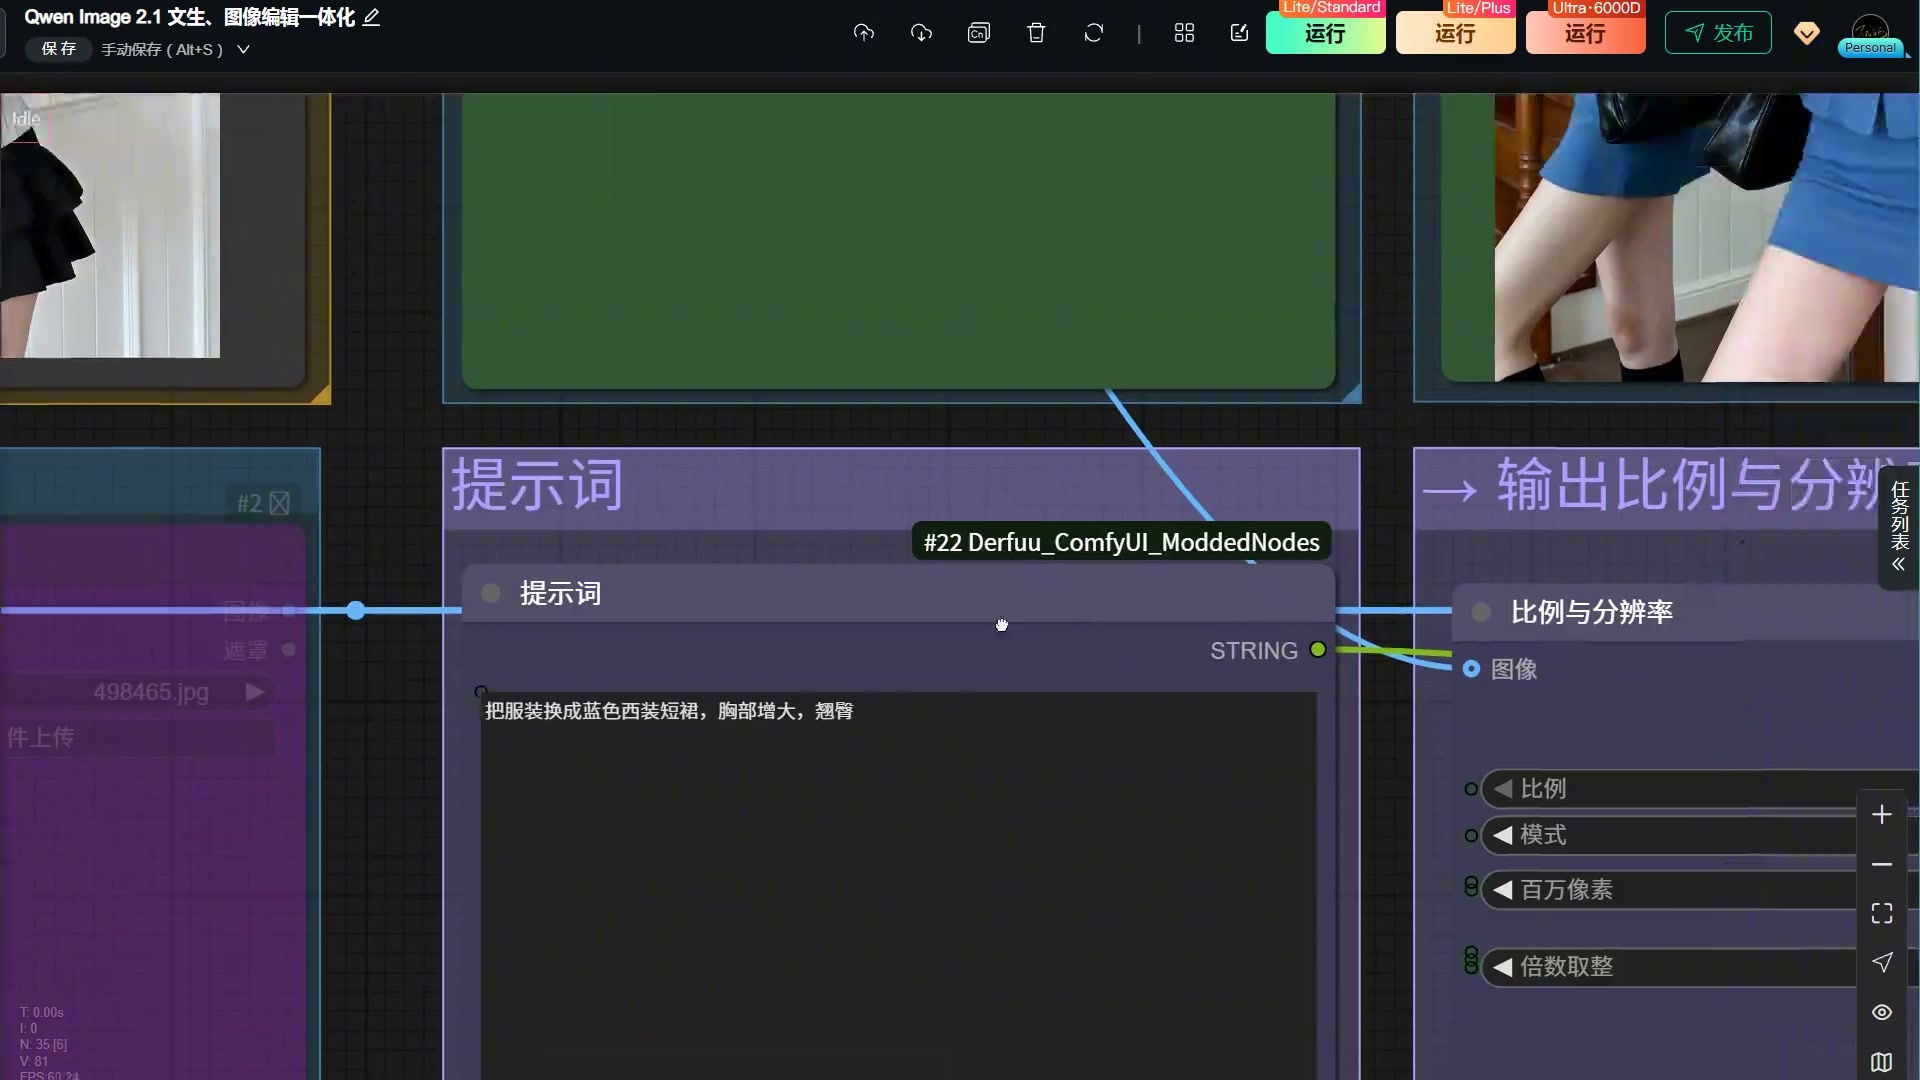
上传人物图,提示词仅需输入“把西装换成蓝色休闲服,身材稍微修长一些”,即可在保持原图五官、光影完全不变的前提下实现丝滑换装与微调。
⭕ 4. 官方画圈与多色标签编辑
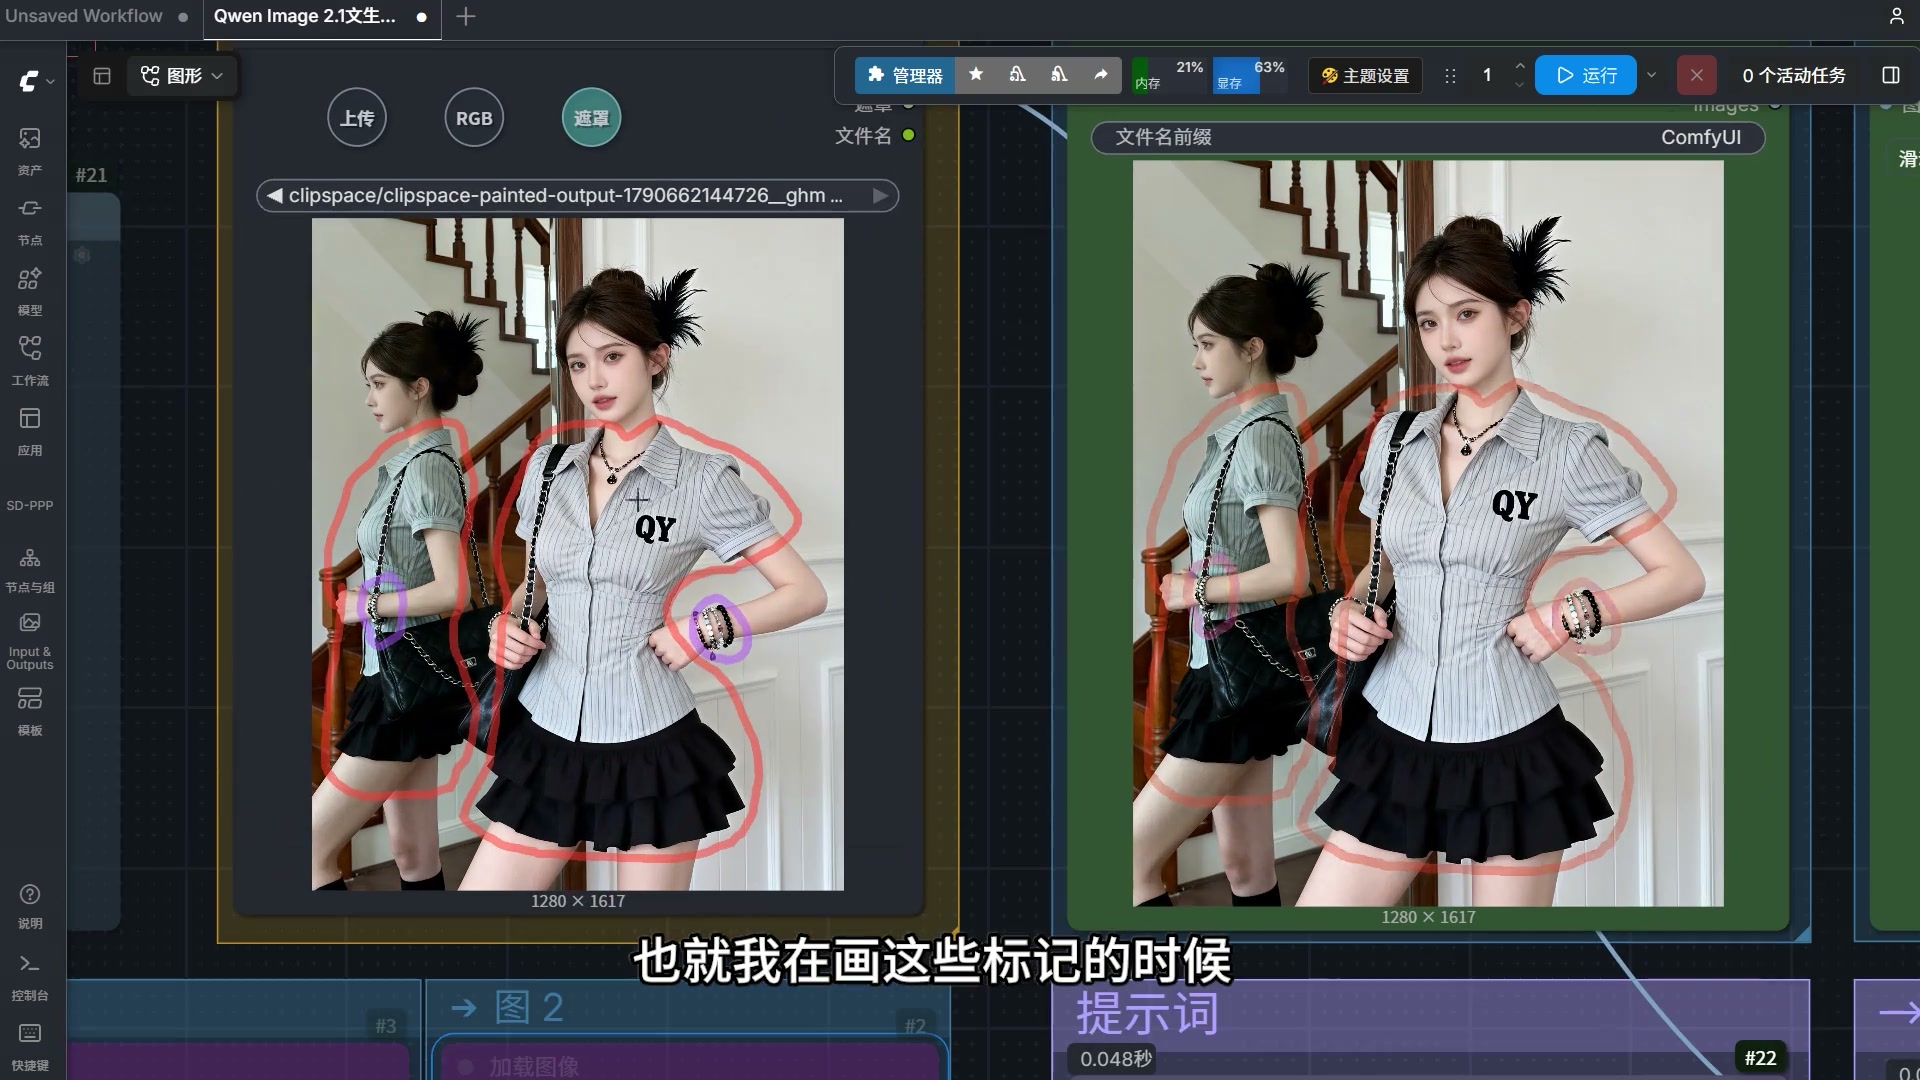
无需繁琐写长 Prompt!用红笔圈出衣服,用紫笔圈出杂物,指令写“把红圈服装换成黑色,移除紫圈物体”,AI 自动按颜色标签精准定点动手术!
💎 5. RGBA 原生 4 通道透传抠图
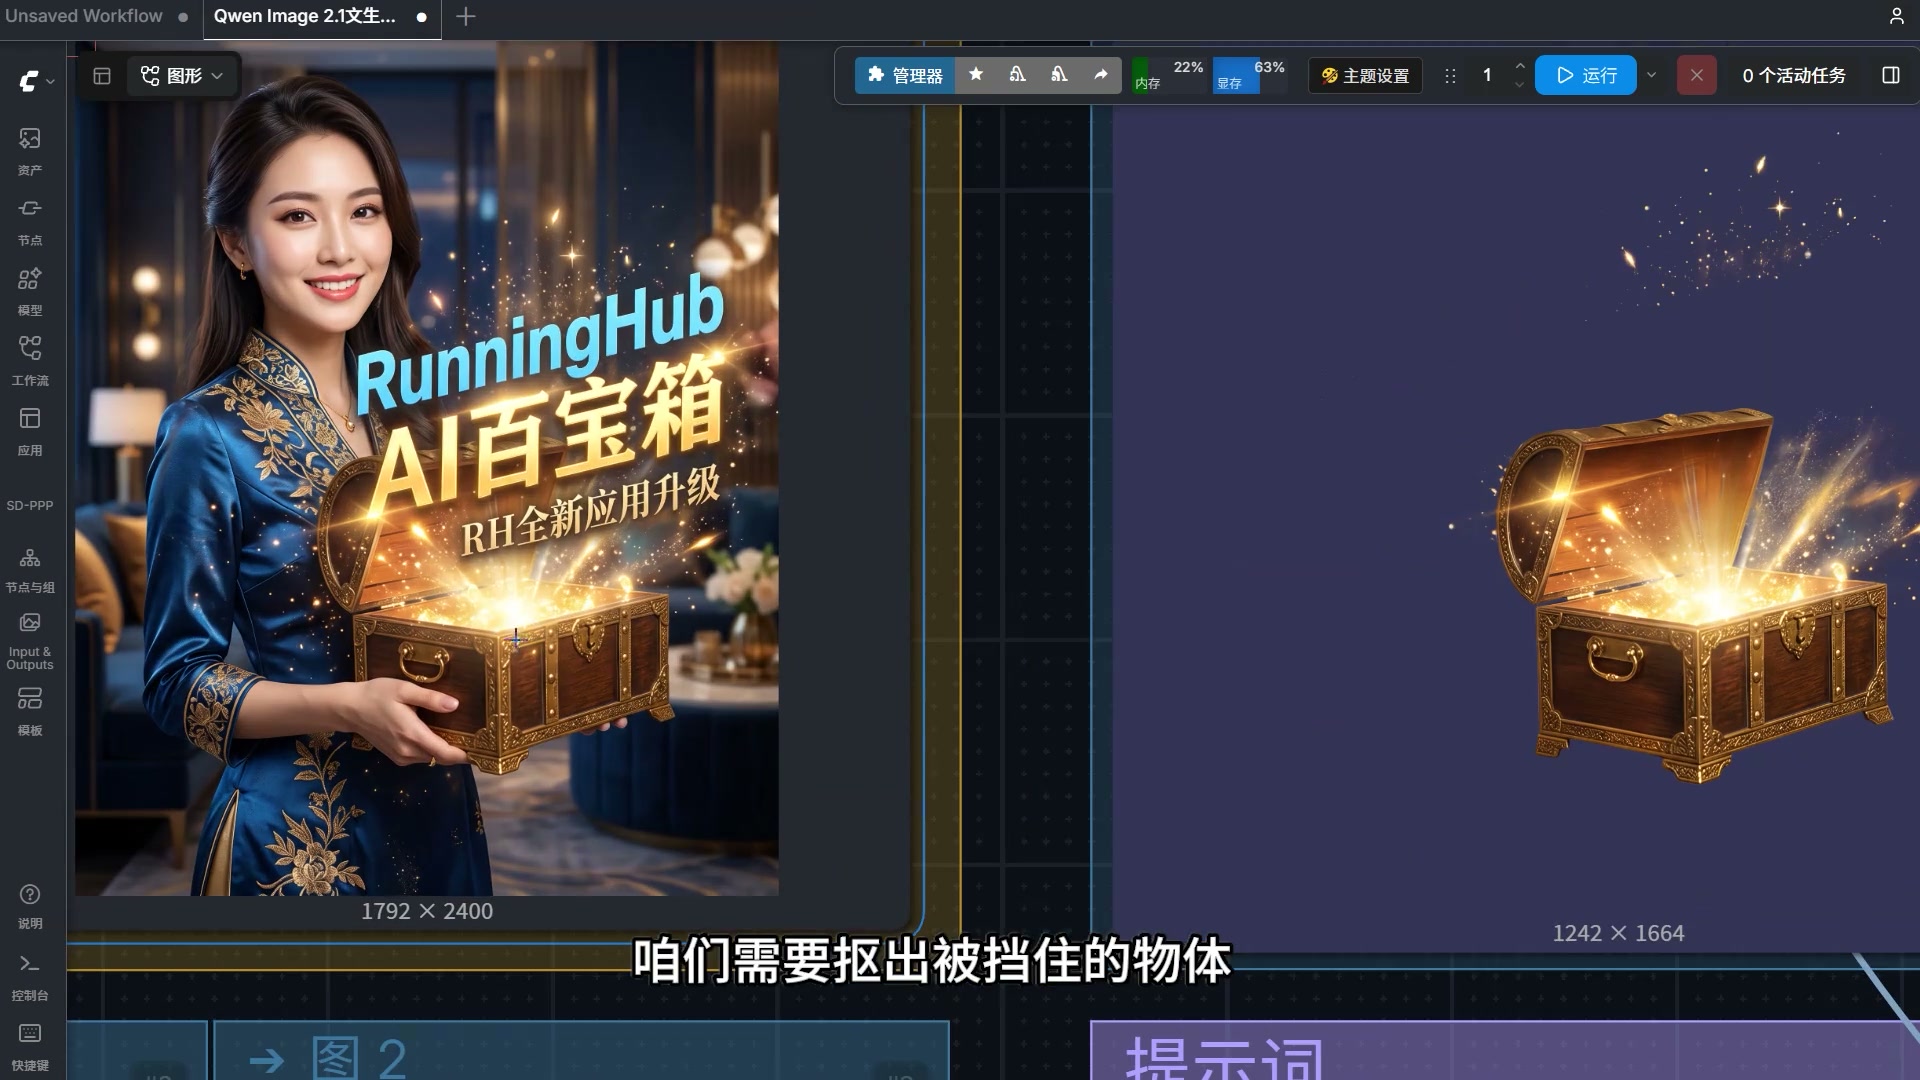
行业首创透明通道保留节点!市面节点多转为 RGB 白底后再二次抠图导致边缘毛边狗牙,而本方案原生直出透明 PNG,连玻璃杯光影倒影都能完整留存!
📐 6. 9:16 到 16:9 无缝智能扩图
手机竖屏照片一键横向扩图为电脑宽屏(16:9),AI 自动脑补两侧光影、延伸街道与树木,边缘毫无拼接过渡痕迹,画质自然延伸。
🔍 7. 千万像素超分辨率直出 (Hi-Res)
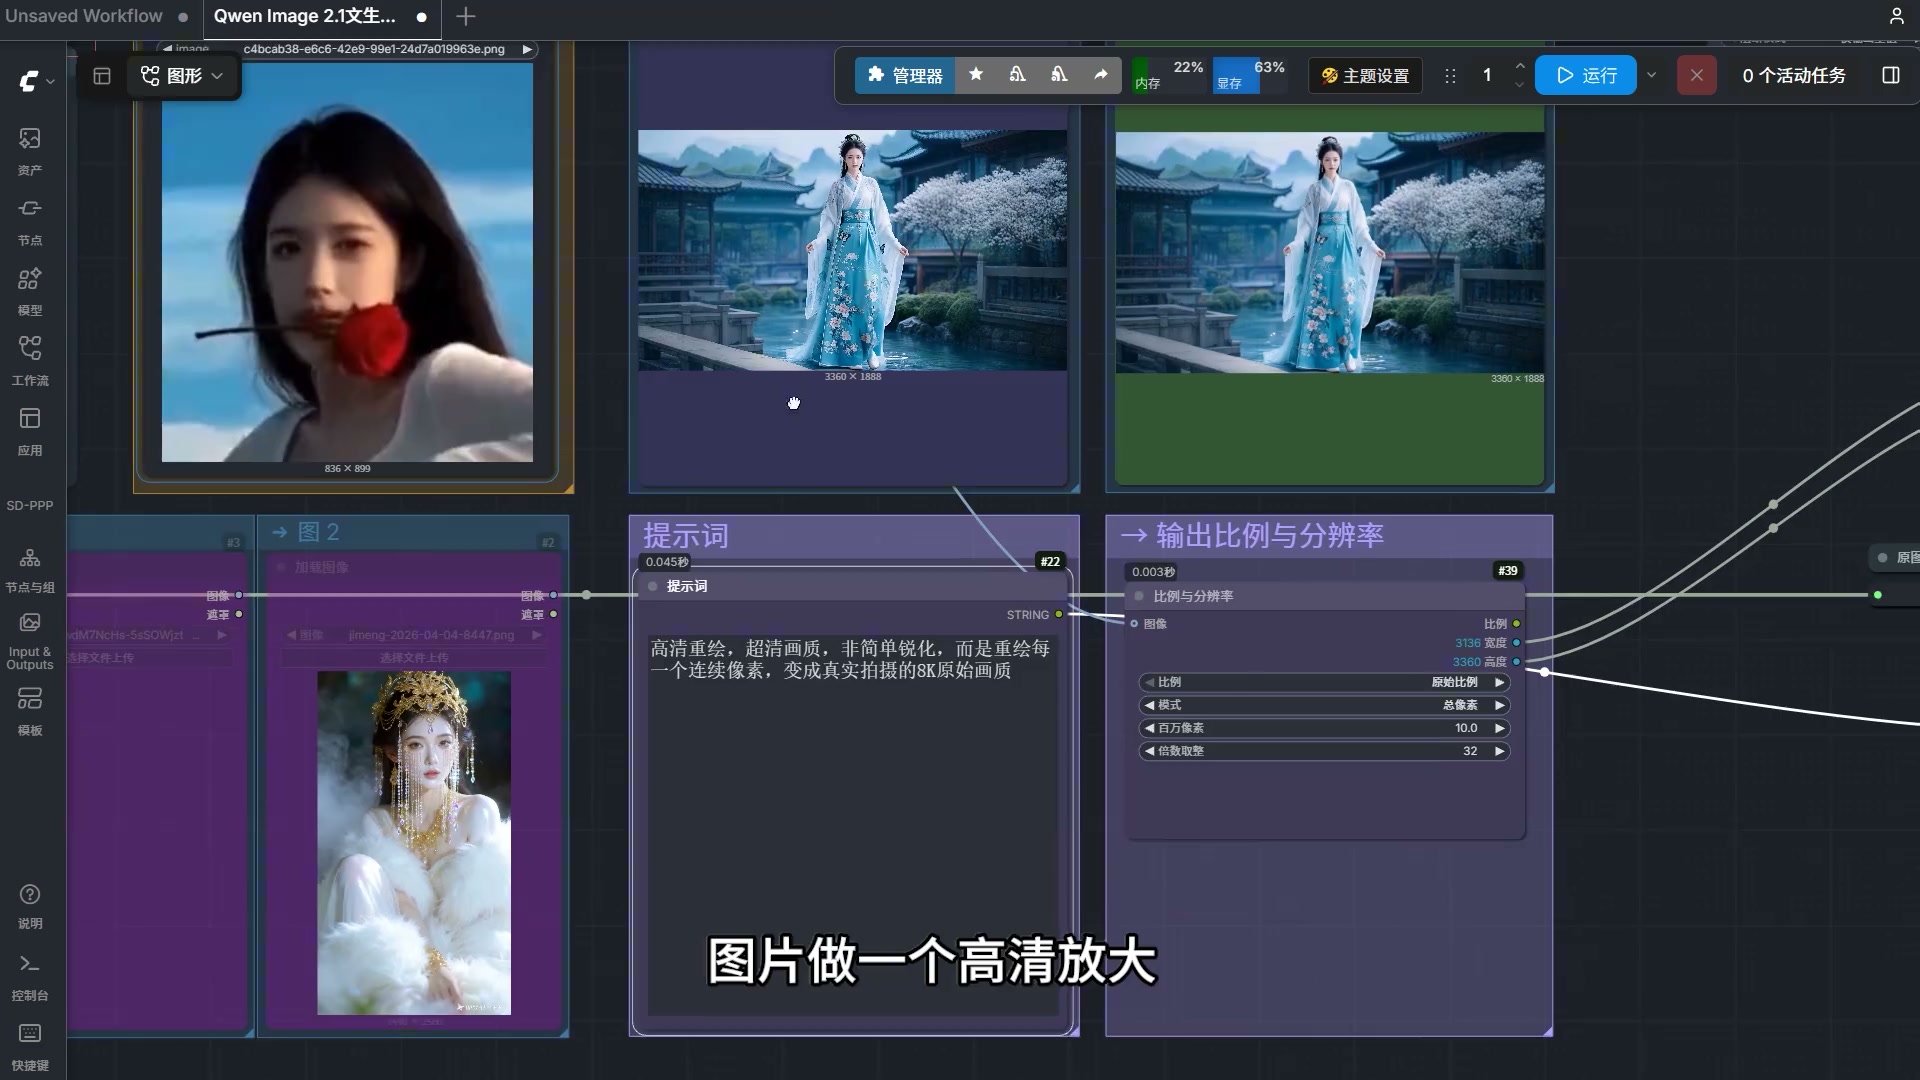
即使是模糊老图或低分辨率素材,调至 1000 万像素(10M)高清修复仅需 14 秒!微观皮肤毛孔、发丝纹理与眼神光细节全部逼真重建。
🕰️ 8. 老照片翻新与严重偏色校正
对发黄褪色、色带溢出或严重噪点的老照片,能还原出通透、自然的冷暖平衡色调,拒绝传统 AI 修复“油腻蜡像人脸”感。
👥 9. 多人同框大合影融合 (6~10人)
支持同时接入 6 到 10 张单人照片,指定“统一聚会场景、后排站4人前排蹲3人”,AI 自动生成高一致性群像合影,手部肢体稳定不崩!
⚡ 10. 智能 32 倍像素对齐防拉伸
前向空间潜变量严格以 32 像素为单位整除,非标图片自动补全 Padding 后再切回,杜绝任何画质畸变拉伸。
三、 本地部署条件与低显存优化方案(8G/12G/16G 实测)
很多小伙伴担心 2026 前沿大模型“只有 4090 才能跑”,Qwen Image 2.1 官方与社区生态对消费级硬件极其友好!
| 用户显卡级别 | 实测显存要求 | 推荐模型格式 | 生成耗时 (400万像素) | 画质与工程建议 |
|---|---|---|---|---|
| 旗舰级 (RTX 4090 / 3090 / 4080) | 16GB ~ 24GB VRAM | BF16 官方满血版 | 约 12 ~ 18 秒 | 画质细节无损,商业交付首选 |
| 主流甜品级 (RTX 4070 / 4070Ti / 3080) | 12GB VRAM | GGUF Q8_0 / Int8 | 约 22 ~ 28 秒 | 显存占用仅 9GB 左右,画质几乎无肉眼差异 |
| 入门级 / 笔记本 (RTX 4060 / 3060 / 2080Ti) | 8GB VRAM 起步 | GGUF Q4_K_M / Int4-8 | 约 35 ~ 45 秒 | 开启低显存卸载(LowVRAM),日常创作畅玩 |
🛠️ 本地 ComfyUI 必备节点与依赖避坑:
- ComfyUI 官方核心更新:确保 ComfyUI 升级至支持多模态 Diffusion Transformer 架构的最新版;
- TeaCache 采样加速节点:核心加速黑科技!通常开启后只需 30 步(Steps) 采样即可出片,速度提升 2~3 倍且视觉无损;
- 提示词优化节点(LLM/VQA):需要环境支持
llama-cpp-python。如果遇到编译报错,请直接使用编译好的 Prebuilt whl 包安装; - 快捷键操作秘籍:
- 在图像节点上选中后按
Z键,秒级呼出智能平滑遮罩编辑器(无论原图几千万像素,画布自动等比平滑缩放至 1536 视口,画完自动映射回原图,绝不掉帧卡顿); - 快捷键
A-F快速切换自动填充遮罩闭合,工作流效率飙升 5 倍!
- 在图像节点上选中后按
☁️ 云端免配置玩法(RunningHub)
如果电脑暂时没有独立显卡或者外出办公,该全功能工作流同样原生支持在 RunningHub 在线平台一键载入运行。按需调用云端 4090 算力,手机、轻薄本打开浏览器也能秒级生图!
四、 商业化变现思考:超级个体的视觉生产力重构
过去做一个淘宝/亚马逊详情页、做一条小红书爆款图文,需要请专业摄影师、修图师、排版美工,单件成本上千元。而通过 Qwen Image 2.1 万能工作流,一个人就能完成:
- 白底图一键变奢侈品光影大片(反推洗图 + 换背景);
- 真人模特免上身换装(多图融合 + 局部换装);
- 透明主图免抠直出(RGBA 四通道输出直接拖入 PS/Canva 设计);
- 老旧商品图升格为 4K 超清详情页(1000 万像素超分辨率修复)。
🛡️ 极致算力后盾 · 大娃数字杂货铺
算力现货 · 商业变现直通车
想要让本地视觉模型与海外顶级大模型(Claude 5.5 / GPT-6 Astra)协同工作,一键批量写商业提示词与分镜?
• Claude 5.5 / Opus 独享版:海外住宅专线直连,一人一号,专为高阶 AI 提示词工程与复杂工作流打造;
• Midjourney / ChatGPT Plus:正规免税区直充,全币种代付支持与 30 天质保;
• 商业视觉样张库:同步访问伙伴站 美研智享 (meinvnv.com),获取 74+ 组商业爆款视觉 Prompt 与 ComfyUI 现成调参资产!